Сервис передачи сообщений аудита (idmx-datapipe)#
Сервис передачи сообщений аудита позволяет повысить отказоустойчивость при передаче сообщений аудита в Platform V Audit. idmx-datapipe является дополнительным сервисом, который получает сообщения из системной БД IDM (или из БД хранения сообщений аудита, при использовании раздельного хранения данных), преобразует их в соответствующий формат, и отправляет их в Kafka целевой инсталляции Platform V Audit.
Обработка и отправка осуществляется блоками (chunk) конфигурируемого размера. В случае ошибок обработки или отправки сообщений блока, блок будет добавлен для повторной отправки, пока он не будет успешно доставлен в Kafka.
Для подключения idmx-datapipe следует установить параметр enabled в значение true для блока idmx-datapipe в корневом файле конфигурации, а также корректно заполнить параметры подключения к БД с данными аудита и к Kafka.
Аппаратные требования idmx-datapipe#
Контейнер модуля требует следующую минимальную конфигурацию ресурсов:
CPU — 1
ephemeral-storage — 1Gi
memory — 2Gi
Также для сервиса требуется развернуть БД для хранения служебной информации. Минимальной рекомендуемой конфигурацией для БД является 4 ядра/8 ГБ RAM/200 ГБ дискового пространства.
Более подробная информация по сайзингу БД приведена в разделе Системные требования.
Обратите внимание.
В зависимости от объема потока передаваемых сообщений может возникнуть необходимость увеличить выделяемые контейнеру ресуры.
Рекомендации по развертыванию БД idmx-datapipe#
Оптимальной конфигурацией для idmx-datapipe является один из следующих вариантов:
БД IDM мастер + реплика,
idmx-datapipeчитает данные из реплики БД IDM.БД аудита мастер + реплика,
idmx-datapipeчитает данные из реплики БД аудита, и дополнительную информацию для обогащения событий из БД IDM.
Допустимо развернуть БД idmx-datapipe на том же хосте, на котором расположена БД аудита.
Опционально возможно развертывание схемы с таблицами БД Datapipe в той же СУБД, на которой развернута БД аудита IDM. Для того, чтобы Datapipe и IDM попадали в нужные схемы - следует:
Создать в БД разных пользователей (например,
idm-audit-userдля работы с БД аудита иidm-datapipe-userдля работы с БД Datapipe).В настройках созданных пользователей указать, с какой схемой они работают через параметр
search_path.Указать этих пользователей в соответствующих секретах (
datapipe_db_passwordиdatapipe_db_username, иidm_engine_repository_db_audit_usernameиidm_engine_repository_db_audit_passwordсоответственно).
Обратите внимание.
Данная опция развертывания не рекомендуется для эксплуатации, так как увеличивает нагрузку и потребление ресурсов СУБД.
Скорость обработки (чтение данных из БД + отправка данных в аудит) увеличивается после остановки задачи импорта сотрудников. Это поведение объясянется тем, что после остановки задачи в БД idmx-engine или в БД аудита не идет запись, и скорость работы idmx-datapipe увеличивается. Данное поведение неизменно вне зависимости от конфигурации развертывания БД, из которых читаются данные.
Конфигурация idmx-datapipe#
Credentials#
Для БД idmx-datapipe требуется создать пользователя, под учетной записью которого будут выполняться действия в БД idmx-datapipe. Создаваемому пользователю или ТУЗ потребуются такие же права, как и пользователю idm_user, созданному для БД IDM.
Для подключения к БД:
Поместите в SecMan по пути
<НУЖНОЕ>/<ПРОСТРАНСТВО>/<В>/<SECMAN>/passwords_confдва секрета (значения не в base64):"datapipe_db_password": "<пароль учетной записи пользователя БД datapipe>";"datapipe_db_username": "<имя пользователя БД datapipe>".
Если для подключения к БД требуется mTLS (смотрите раздел Защита соединения с БД по SSL и типы Service Mesh): Добавить секреты в систему хранения секретов (vault/Secret Management System или Kubernetes Secrets):
postgres_datapipe_cert— сертификат для mTLS к БД аудита;postgres_datapipe_pk8(rhsm) илиpostgres_datapipe_key(synapse) — ключ для mTLS к БД аудита;postgres_datapipe_ca— сертификат CA для mTLS к БД аудита.
Для подключения к Kafka Platform V Audit/Platform V Monitor требуется добавить сертификаты mTLS:
Если используется Platform V Synapse Service Mesh (Istio):
Поместите в хранилище (vault) Secret Management System следующие сертификаты, зашифрованные в base64, с такими названиями:
datapipe_kafka_ca— Сертификат CA для Kafka;datapipe_kafka_cert— Клиентский сертификат для Kafka;datapipe_kafka_key— Клиентский ключ для Kafka;
Если не используется Platform V Synapse Service Mesh:
Получите сертификаты для mTLS к Kafka (
datapipe_kafka_ca,datapipe_kafka_cert,datapipe_kafka_key).Поместите их в keystore с именем
datapipe_keystore.jks.Поместите в хранилище (vault) Secret Management System следующие credentials, зашифрованные в base64, с такими названиями:
datapipe_keystore- keystore, созданный на шаге 2.datapipe_keystore_password- пароль для keystore, созданного на шаге 2.datapipe_keystore_key_password- пароль для сертификатов в keystore, созданном на шаге 2.
Альтернативно, вместо добавления сертификатов из пунктов 2 и 3 вручную можно воспользоваться механизмом генерации сертификатов Secret Management System (или Hashicorp Vault). Для этого следует заполнить параметры групп secman.pkiSecretsEngine.postgresDatapipe и secman.pkiSecretsEngine.datapipeKafka.
Обратите внимание.
Если при использовании
pkiSecretsEngineне используется интеграция с Platform V Synapse Service Mesh (Istio) - SecMan не сможет сгенерировать сертификаты для Kafka Platform V Audit/Platform V Monitor и ключ для БДidmx-datapipeв формате pk8.Данные секреты в такой комбинации интеграций следует сформировать и поместить в vault вручную согласно инструкции выше. Для сертификатов Kafka воспользуйтесь шагом без использования Platform V Synapse Service Mesh (формирование keystore).
Доступ в БД IDM#
Для доступа в БД IDM (и БД аудита при использовании раздельного хранения) idmx-datapipe использует секреты, загруженные в систему хранения секретов, для этих БД.
В систему хранения секретов следует добавить следующие секреты для Datapipe:
datapipe_engine_db_username- имя пользователя для доступа к БД IDM.datapipe_engine_db_password- пароль для доступа к БД IDM.datapipe_audit_db_username- имя пользователя для доступа к БД аудита.datapipe_audit_db_password- пароль для доступа к БД аудита.
Конфигурационные параметры#
Конфигурационные параметры, относящиеся к idmx-datapipe расположены в корневом файле конфигурации IDM values.yaml в директории /conf/helm/application/idmx/.
# Модуль, осуществляющий аггрегацию, обработку и отправку сообщений аудита при интеграции с внешними системами аудита
datapipe:
  enabled: false
  # Аннотации для всех ресурсов сервиса (Deployment, Service, ConfigMap и т.д.). Применяются к metadata.annotations каждого ресурса
  annotations: {}
    # argocd.argoproj.io/sync-wave: '-2'
  # Аннотации для Pod. Применяются к spec.template.metadata.annotations в Deployment
  podAnnotations: {}
  # Количество реплик приложения idmx-datapipe
  replicas: 1
  # Наименование kubernetes secret, который будет использовать idmx-datapipe
  secretName: "idmx-secrets"
  # Настройка используемого образа idmx-datapipe
  image:
    # Адрес реестра с образами. Если не указан, используется значение переменной global.registry
    registry: ""
    # Название репозитория в реестре, где находится образ
    repository: ""
    # Тег образа
    tag: ""
    # Хэш образа, начинается с 'sha256:'. Если указан, имеет приоритет над тегом
    digest: ""

  # Подключение к БД idmx-datapipe
  database:
    enabled: true
    # Использовать mTLS при подключении к БД idmx-datapipe
    # При использовании MTLS без Service Mesh или с RedHat Service Mesh:
    # jdbc:postgresql://db-hostname:127.0.0.1:5432/db-name?prepareThreshold=0&ssl=true&sslmode=verify-full&sslcert=/vault/secrets/postgres-datapipe/postgres_datapipe_cert&sslkey=/vault/secrets/postgres-datapipe/postgres_datapipe_pk8&sslrootcert=/vault/secrets/postgres-datapipe/postgres_datapipe_ca
    # При использовании MTLS и Synapse Service Mesh:
    # jdbc:postgresql://db-hostname:127.0.0.1:5432/db-name?prepareThreshold=0&sslmode=disable
    mtls: true
    # URL, по которому IDMX будет подключаться к системной БД. <DB_EXTERNAL_PORT> указывается обязательно. Значения перечисляются через ',' в формате:
    # <DB_HOST>:<DB_IP>:<DB_EXTERNAL_PORT>, где:
    # <DB_HOST> — FQDN узла, на котором расположена системная БД IDMX (обязательно для работы с Service Mesh);
    # <DB_IP> — IP-адрес узла (обязательно для работы с Service Mesh);
    # <DB_EXTERNAL_PORT> — порт внешнего узла (сервера с системной БД).
    url: "jdbc:postgresql://db-hostname:127.0.0.1:5432/db-name?prepareThreshold=0&sslmode=disable"
    # # Настройки пула подключений к БД
    # (полное описание см. в настройках HikariCP: https://github.com/brettwooldridge/HikariCP)
    hikariCP:
      # Настройки подключения к БД idmx-datapipe
      datapipe:
        # Минимальное количество соединений в пуле
        minPoolSize: 2
        # Максимальное количество соединений в пуле
        maxPoolSize: 10
        # Максимальное время жизни соединения в пуле
        maxLifetime: 0
        # Время, в течение которого соединению разрешено простаивать в пуле
        idleTimeout: 600000
        # Как часто нужно посылать запросы (ping) через соединение, чтобы предотвратить его тайм-аут из-за базы данных или сетевой инфраструктуры (0 - отключено)
        keepaliveTime: 0
        # Время, в течение которого соединение может находиться вне пула, прежде чем будет зарегистрировано сообщение, указывающее на возможную утечку соединения (0 - отключено)
        leakDetectionThreshold: 0
        # Максимальное время, в течение которого клиент будет ждать соединения из пула
        connectionTimeout: 30000
        # Время, в течение которого соединение будет проверяться на работоспособность
        validationTimeout: 5000
        # Время, по истечению которого пул будет выходить из строя (fail-fast), если он не может быть успешно проинициализирован.
        initializationFailTimeout: 1
        # Максимальное время ожидания ответа от БД
        networkTimeout: 60000
        # Значение тайм-аута, используемое для операций чтения.
        socketTimeout: 30
      # Настройки подключения к основной БД idmx-engine
      main:
        # Минимальное количество соединений в пуле
        minPoolSize: 2
        # Максимальное количество соединений в пуле
        maxPoolSize: 10
        # Максимальное время жизни соединения в пуле
        maxLifetime: 0
        # Время, в течение которого соединению разрешено простаивать в пуле
        idleTimeout: 600000
        # Как часто нужно посылать запросы (ping) через соединение, чтобы предотвратить его тайм-аут из-за базы данных или сетевой инфраструктуры (0 - отключено)
        keepaliveTime: 0
        # Время, в течение которого соединение может находиться вне пула, прежде чем будет зарегистрировано сообщение, указывающее на возможную утечку соединения (0 - отключено)
        leakDetectionThreshold: 0
        # Максимальное время, в течение которого клиент будет ждать соединения из пула
        connectionTimeout: 30000
        # Время, в течение которого соединение будет проверяться на работоспособность
        validationTimeout: 5000
        # Время, по истечению которого пул будет выходить из строя (fail-fast), если он не может быть успешно проинициализирован.
        initializationFailTimeout: 1
        # Максимальное время ожидания ответа от БД
        networkTimeout: 60000
        # Значение тайм-аута, используемое для операций чтения.
        socketTimeout: 30
      # Настройки подключения к БД с аудитом idmx-datapipe, если аудит вынесен в отдельную БД
      audit:
        # Минимальное количество соединений в пуле
        minPoolSize: 2
        # Максимальное количество соединений в пуле
        maxPoolSize: 10
        # Максимальное время жизни соединения в пуле
        maxLifetime: 0
        # Время, в течение которого соединению разрешено простаивать в пуле
        idleTimeout: 600000
        # Как часто нужно посылать запросы (ping) через соединение, чтобы предотвратить его тайм-аут из-за базы данных или сетевой инфраструктуры (0 - отключено)
        keepaliveTime: 0
        # Время, в течение которого соединение может находиться вне пула, прежде чем будет зарегистрировано сообщение, указывающее на возможную утечку соединения (0 - отключено)
        leakDetectionThreshold: 0
        # Максимальное время, в течение которого клиент будет ждать соединения из пула
        connectionTimeout: 30000
        # Время, в течение которого соединение будет проверяться на работоспособность
        validationTimeout: 5000
        # Время, по истечению которого пул будет выходить из строя (fail-fast), если он не может быть успешно проинициализирован.
        initializationFailTimeout: 1
        # Максимальное время ожидания ответа от БД
        networkTimeout: 60000
        # Значение тайм-аута, используемое для операций чтения.
        socketTimeout: 30

  # Настройка отправки сообщений аудита в Kafka
  kafka:
    enabled: true
    # Параметр определяет, будет ли использоваться mTLS для подключения к Kafka
    mtls: true
    # Параметр определяет брокеров Kafka, через которых будут отправляться сообщения аудита IDMX.
    # Значения перечисляются через ',' в формате <HOST>:<IP>:<PORT>, где:
    # <HOST> — FQDN внешнего узла;
    # <IP> — IP-адрес внешнего узла;
    # <PORT> — порт внешнего узла.
    brokers: "kafka-hostname:127.0.0.1:9093"
    # Параметр определяет топики Kafka, в которых будут отправляться сообщения аудита IDMX
    eventTopic: "event"
    # Параметр определяет топики Kafka для метамоделей
    metamodelTopic: "metamodel"
    # Максимальное время ожидания ответа от Kafka
    requestTimeoutMs: 10000
    # Максимальное время отправки сообщения в Kafka, включая время отправки, ожидание ответа и т.д.
    # Должно быть больше чем requestTimeoutMs
    deliveryTimeoutMs: 11000

  # Дополнительные опции запуска для Java-машины
  javaOptsExtra: "-XX:+AlwaysPreTouch -server -XX:InitialRAMPercentage=50.0 -XX:+UseContainerSupport -XX:MaxRAMPercentage=70.0 -XX:+UseG1GC -XX:MaxGCPauseMillis=100"
  # Параметр определяет периодичность запуска сущности инструмента Jenkins (Jenkins job)
  # Например, */10 * * * * * - запуск сущности инструмента Jenkins (Jenkins job) каждые 10 секунд
  cron: "*/10 * * * * *"
  # Время, с которого будут вычитываться события аудита при первом запуске
  # Возможные значения:
  # ZERO - все события из базы
  # NOW - события начиная с текущего момента
  # YYYY-MM-DD HH:MM:SS.sss +HHMM - события с определенной временной метки.
  # При указании таймзоны (+HHMM в значении параметра), необходимо указывать таймзону такую же, как и в БД событий аудита.
  # Например, можно взять значение из поля timestamp таблицы ma_audit_event и вставить его в значение параметра
  initReadFrom: "NOW"
  # Размер обрабатываемого блока событий
  chunkSize: 10
  # Количество событий считываемых из базы одним запросом
  auditReadPageSize: 80
  # Количество потоков, обрабатывающих события аудита
  workersPoolSize: 4
  # Период между проверкам доступности БД аудита
  dbHealthCheckPeriodMs: 10000
  # Максимальное время проверки доступности кафки
  kafkaHealthCheckTimeoutMs: 10000
  # Настройка политик повторов операций при возникновении ошибок
  retryPolicies:
    # Количество попыток на этапе чтения (1 - общее количество попыток, включая первую)
    readerMaxAttempts: 1
    # Количество попыток на этапе маппинга (1 - общее количество попыток, включая первую)
    processorMaxAttempts: 1
    # Количество попыток на этапе отправки в кафку (1 - общее количество попыток, включая первую)
    writerMaxAttempts: 1
  # Настройка обновления секретов в рантайме (без перезапуска контейнера)
  secretsHotReload:
    enabled: true
    # Количество попыток считывания нового секрета после обновления (в случае ошибок считывания)
    maxReadAttempts: 3
    # Период между повторными попытками считывания секрета (в случае ошибок)
    retryDelaySec: 10
    # Период между считываниями секрета в секундах
    pollingPeriodSec: 60
    # Поведение при неуспешном обновлении: FAIL_SAFE - продолжить работу со старыми секретами, FAIL_FAST - завершить работу с ошибкой
    hotReloadStrategy: "FAIL_SAFE"

  # Настройка включения кэширования объектов ResourceType, TaskType, ArchetypeType
  cache:
    enabled: true
    # Максимальное количество объектов в кэше
    maximumSize: 100
    # Время, после которого записи удаляются из кэша
    # Например, P2DT3H4M преобразуется в 2 дня, 3 часа и 4 минуты
    expireAfterWrite: "P1D"
    # Включение статистики кэша в метриках
    recordMetrics: true

  # Настройка интеграции с Prometheus для idmx-datapipe
  prometheus:
    # Параметр определяет, включен ли сбор данных Prometheus
    scrape: true
    # Порт, на котором Prometheus будет осуществлять сбор данных
    port: 9090
    # Путь, по которому Prometheus может получить данные
    path: "/actuator/prometheus"

  # Вычислительные ресурсы, необходимые контейнеру idmx-datapipe
  resources:
    requests:
      # Количество ядер процессора, которое будет запрошено для контейнера
      cpu: 1
      # Минимальный объем оперативной памяти, который будет запрошен для контейнера
      memory: 2Gi
      # Минимальный объем временного хранилища, который будет запрошен для контейнера
      ephemeral-storage: 1Gi
    limits:
      # Максимальное количество ядер процессора, которое будет выделено для контейнера
      cpu: 1
      # Максимальный объем оперативной памяти, который будет выделен для контейнера
      memory: 2Gi
      # Максимальный объем временного хранилища, который будет выделен для контейнера
      ephemeral-storage: 1Gi

  # Настройка проверки готовности контейнера idmx-datapipe
  readinessProbe:
    # Количество секунд, которое должно пройти после запуска контейнера, прежде чем начнется проверка готовности
    initialDelaySeconds: 30
    # Максимальное количество времени ожидания для каждой проверки готовности
    timeoutSeconds: 2
    # Интервал между последовательными проверками готовности
    periodSeconds: 10
    # Количество последовательных успешных проверок, необходимых для того, чтобы считать контейнер готовым
    successThreshold: 1
    # Количество последовательных неудачных проверок, после которых контейнер считается неготовым
    failureThreshold: 15
  # Настройка проверки жизнеспособности контейнера idmx-datapipe
  livenessProbe:
    # Количество секунд, которое должно пройти после запуска контейнера, прежде чем начнется проверка жизнеспособности
    initialDelaySeconds: 30
    # Максимальное количество времени ожидания для каждой проверки жизнеспособности
    timeoutSeconds: 2
    # Интервал между последовательными проверками жизнеспособности
    periodSeconds: 10
    # Количество последовательных успешных проверок, необходимых для того, чтобы считать контейнер активным
    successThreshold: 1
    # Количество последовательных неудачных проверок, после которых контейнер считается неактивным
    failureThreshold: 15

  # Приоритет выполнения для idmx-datapipe в кластере
  priorityClassName: null
  # Включение распределения экземпляров idmx-datapipe по разным узлам среды исполнения.
  # Если true - планировщик попытается распределить экземпляры idmx-datapipe по разным узлам.
  # При невозможности такого распределения, экземпляры все равно будут запланированы.
  selfAntiAffinity: false
  # Стратегия обновления, которая определяет, как заменяются старые поды новыми.
  strategy:
    # 'Recreate' — удаляет все существующие поды перед созданием новых.
    # 'RollingUpdate' — заменяет старые ReplicaSets на новые постепенно, уменьшая количество старых реплик и увеличивая новые.
    type: "RollingUpdate"
    # Параметры rolling-обновления. Присутствует только если type = RollingUpdate.
    rollingUpdate:
      # Параметр определяет, сколько подов может быть недоступно во время обновления.
      maxUnavailable: 0
      # Параметр определяет, насколько можно превысить желаемое число подов.
      maxSurge: 25%

  # Настройка атрибутов безопасности
  securityContext:
    # Устанавливает группу пользователей для всех файлов в томе, когда том монтируется в Pod
    fsGroup: null
    # UID, с которым будет запущен контейнер idmx-datapipe
    runAsUser: null
    # GID, с которым будет запущен контейнер idmx-datapipe
    runAsGroup: null

  # Настройка внешнего источника схемы IDMX для idmx-datapipe
  initConnectorsLoad:
    # container - в случае использования init контейнер, download - в случае загрузки схемы из внешнего сервиса
    type: null
    # если type: download, указываем адрес внешнего ресурса
    source: null
    tries:
      # Количество попыток загрузить коннекторы из внешнего ресурса
      count: 15
      # Время ожидания в секундах, между попытками загрузить коннекторы из внешнего ресурса
      timeout: 3
    # Настройка используемого образа init контейнера
    image:
      # Адрес реестра с образами. Если не указан, используется значение переменной global.registry
      registry: ""
      # Название репозитория в реестре, где находится образ
      repository: ""
      # Тег образа
      tag: ""
      # Хэш образа, начинается с 'sha256:'. Если указан, имеет приоритет над тегом
      digest: ""
    # Вычислительные ресурсы, необходимые init контейнеру
    resources:
      requests:
        # Количество ядер процессора, которое будет запрошено для контейнера
        cpu: 100m
        # Минимальный объем оперативной памяти, который будет запрошен для контейнера
        memory: 128Mi
        # Минимальный объем временного хранилища, который будет запрошен для контейнера
        ephemeral-storage: 128Mi
      limits:
        # Максимальное количество ядер процессора, которое будет выделено для контейнера
        cpu: 200m
        # Максимальный объем оперативной памяти, который будет выделен для контейнера
        memory: 256Mi
        # Максимальный объем временного хранилища, который будет выделен для контейнера
        ephemeral-storage: 256Mi
    # Настройка атрибутов безопасности
    securityContext:
      # UID, с которым будет запущен init контейнер с коннекторами
      runAsUser: null
      # GID, с которым будет запущен init контейнер с коннекторами
      runAsGroup: null

  # Настройка sidecars приложения idmx-datapipe
  sidecars:
    secman:
      # Вычислительные ресурсы, необходимые sidecar контейнеру secman
      resources:
        requests:
          # Количество ядер процессора, которое будет запрошено для контейнера
          cpu: 50m
          # Минимальный объем оперативной памяти, который будет запрошен для контейнера
          memory: 64Mi
          # Минимальный объем временного хранилища, который будет запрошен для контейнера
          ephemeralStorage: 128Mi
        limits:
          # Максимальное количество ядер процессора, которое будет выделено для контейнера
          cpu: 100m
          # Максимальный объем оперативной памяти, который будет выделен для контейнера
          memory: 128Mi
          # Максимальный объем временного хранилища, который будет выделен для контейнера
          ephemeralStorage: 256Mi
      # Настройка атрибутов безопасности
      securityContext:
        # UID, с которым будет запущен sidecar контейнер secman
        runAsUser: null
        # GID, с которым будет запущен sidecar контейнер secman
        runAsGroup: null
    mesh:
      # Вычислительные ресурсы, необходимые sidecar контейнеру Service Mesh
      resources:
        requests:
          # Количество ядер процессора, которое будет запрошено для контейнера
          cpu: 400m
          # Минимальный объем оперативной памяти, который будет запрошен для контейнера
          memory: 512Mi
        limits:
          # Максимальное количество ядер процессора, которое будет выделено для контейнера
          cpu: 400m
          # Максимальный объем оперативной памяти, который будет выделен для контейнера
          memory: 1Gi
Принцип работы idmx-datapipe#
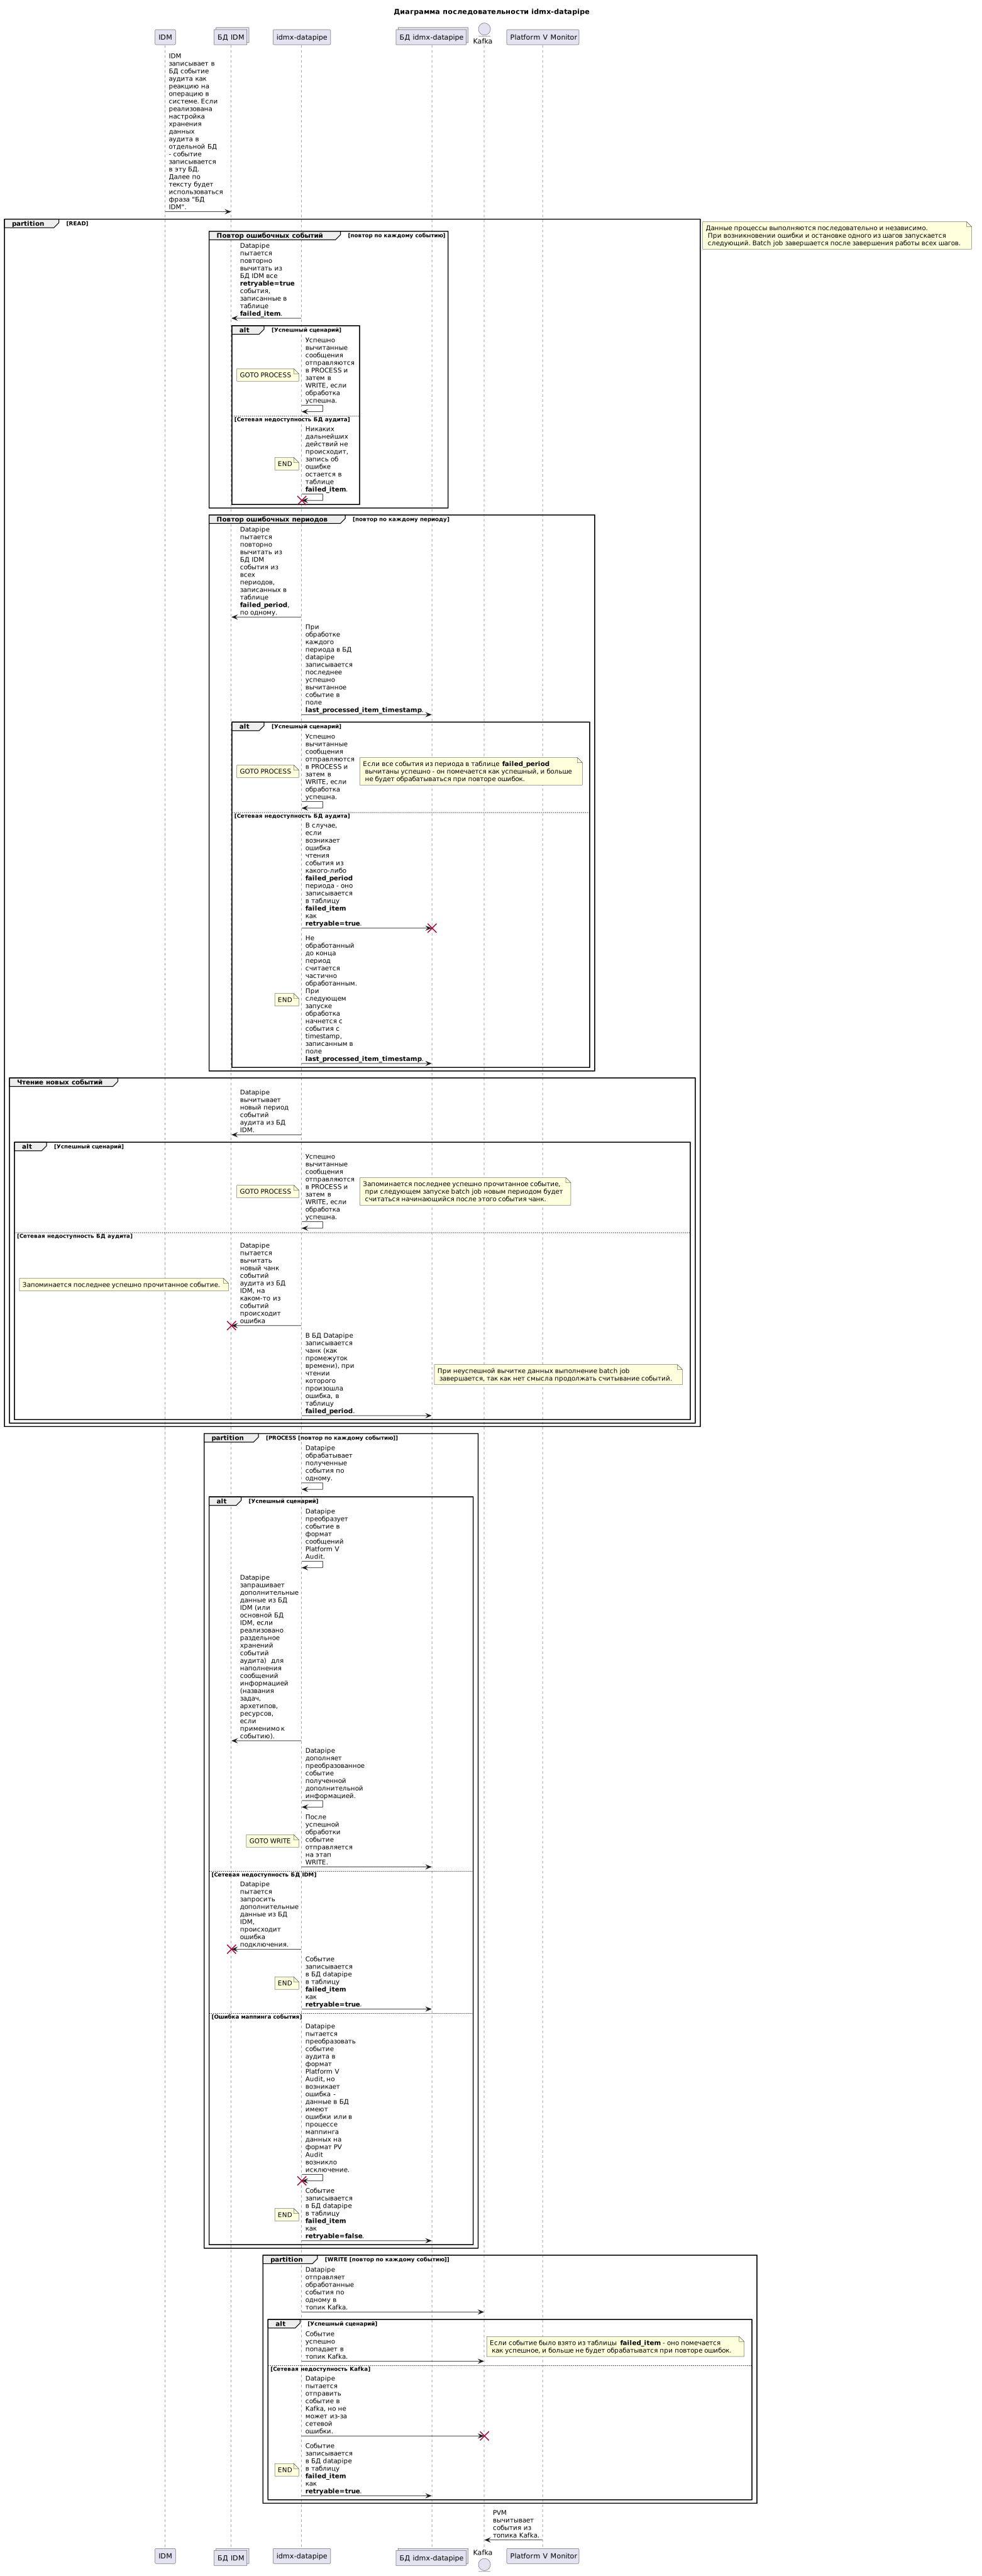
idmx-datapipe является сервисом передачи сообщений аудита, регистрируемых IDM, во внешнюю систему (Platform V Audit или Platform V Monitor). Верхнеуровнево алгоритм работы имеет три этапа выглядит следующим образом:
Чтение данных (READ).
На данном этапе
idmx-datapipeвычитывает события аудита из БД IDM (либо БД хранения событий аудита, если реализована настройка раздельного хранения событий аудита). Вычитка сообщений выполняется с определенного момента (параметрinitReadFrom) блоками (chunk) (размер блока задается параметромchunkSize).Обработка, фильтрация и маппинг данных (PROCESS).
На данном этапе выполняется обработка событий аудита. Данные IDM преобразуются в формат Platform V Audit, и сообщения дополняются данными из основной БД IDM (названия задач, архетипов, ресурсов).
Запись и отправка обработанных данных в целевую систему (WRITE).
На данном этапе обработанные события отправляются в Kafka Platform V Audit.
Определение периодов событий для обработки#
idmx-datapipe обрабатывает события блоками, определяемыми по временным рамкам - периодам. Новый период начинается с timestamp последнего успешного запуска batch job, и закачивается на timestamp текущего запуска batch job.
Таким образом, параметр конфигурации datapipe.cron косвенно отвечает за размер периода, из которого будут вычитываться сообщения аудита, поскольку он отвечает за периодичность запуска batch job idmx-datapipe.
В рамках обрабатываемого периода idmx-datapipe вычитывает
Чанки событий, которые обрабатывает idmx-datapipe, разграничиваются по значению поля timestamp граничных событий чанка. В частности, при обработке чанка новых событий (шаг 3 процесса READ) в БД idmx-datapipe записывается последнее успешно обработанное событие. Следующий чанк новых событий будет вычитываться из БД данных аудита с условнием, что значение поля timestamp строго больше значения этого поля у последнего успешно обработанного события.
Таблицы БД idmx-datapipe#
idmx-datapipe реализован на основе фреймворка Spring Batch, поэтому в БД содержатся таблицы данного фреймворка:
BATCH_JOB_INSTANCE- информация о каждом экземпляре batch job.BATCH_JOB_EXECUTION- информация о каждом запуске экземпляра batch job.BATCH_JOB_EXECUTION_PARAMS- параметры, с которыми был запущен экземпляр batch job.BATCH_STEP_EXECUTION- информация о выполнении каждого шага экземпляра batch job.BATCH_JOB_EXECUTION_CONTEXT- контекст выполнения batch job.BATCH_STEP_EXECUTION_CONTEXT- контекст выполнения шага batch job.
Более подробная информация приведена в документации на Spring Batch.
Дополнительно, для работы idmx-datapipe были добавлены две таблицы:
Таблица
failed_itemсодержит записи о конкретных событиях аудита, которые не были обработаны.CREATE TABLE failed_item ( id uuid NOT NULL, -- UUID записи в БД datapipe job_name varchar NOT NULL, -- Имя batch job, в которой обрабатывалось событие item varchar NOT NULL, -- ID события аудита в БД IDM retryable bool NOT NULL, -- Будет ли событие обрабатываться повторно при следующем запуске batch job fail_reason varchar NULL, -- Сообщение об ошибке, из-за которой событие не было обработано processed bool NULL, -- Флаг обработки, если событие успешно обработано - флаг ставится в true, событие больше не будет обрабатываться при повторах ошибок create_timestamp timestamp NULL, -- Время создания записи в БД datapipe last_modify_timestamp timestamp NULL, -- Время последнего изменения записи CONSTRAINT failed_item_pkey PRIMARY KEY (id), CONSTRAINT unique_item UNIQUE (item) ); CREATE INDEX failed_item_job_retryable ON public.failed_item USING btree (job_name, retryable, processed);Таблица
failed_periodсодержит записи о периодах (чанках) событий аудита, которые не были обработаны.CREATE TABLE failed_period ( id uuid NOT NULL, -- UUID записи в БД datapipe job_name varchar NOT NULL, -- Имя batch job, в которой обрабатывалось событие start_period varchar NOT NULL, -- timestamp первого события периода end_period varchar NOT NULL, -- timestamp последнего события периода fail_reason varchar NULL, -- Сообщение об ошибке, из-за которой событие не было обработано processed bool NULL, -- Флаг обработки, если период успешно обработан - флаг ставится в true, период больше не будет обрабатываться при повторах ошибок last_processed_item_timestamp varchar NULL, -- Значение поля timestamp у последнего успешно обработанного события в периоде create_timestamp timestamp NULL, -- Время создания записи в БД datapipe last_modify_timestamp timestamp NULL, -- Время последнего изменения записи CONSTRAINT failed_period_pkey PRIMARY KEY (id), CONSTRAINT unique_period UNIQUE (start_period, end_period) ); CREATE INDEX failed_period_job ON public.failed_period USING btree (job_name, processed);
Политика повторов#
Кроме повторной обработки ошибок, происходящей в рамках алгоритма работы idmx-datapipe, также происходит повтор ошибок в момент их возникновения, до того, как idmx-datapipe пойдет по неуспешному сценарию и создаст запись в БД.
В конфигурации idmx-datapipe можно задать максимальное количество таких повторов для каждого из шагов алгоритма работы в блоке datapipe.retryPolicies.
Кеширование данных#
Для снижения нагрузки на основную БД IDM при большом количестве запросов, реализован механизм кеширования данных объектов типа TaskType, ResourceType и ArchetypeType, используемых для насыщения дополнительной информацией событий аудита перед отправкой в Kafka.
Кеш обновляется после истечения периода хранения кешированных данных по их запросу из БД IDM, период задается в формате Java Duration в параметре конфигурации datapipe.cache.expireAfterWrite.
Кеширование конфигурируется в блоке datapipe.cache в конфигурации idmx-datapipe.
События аудита#
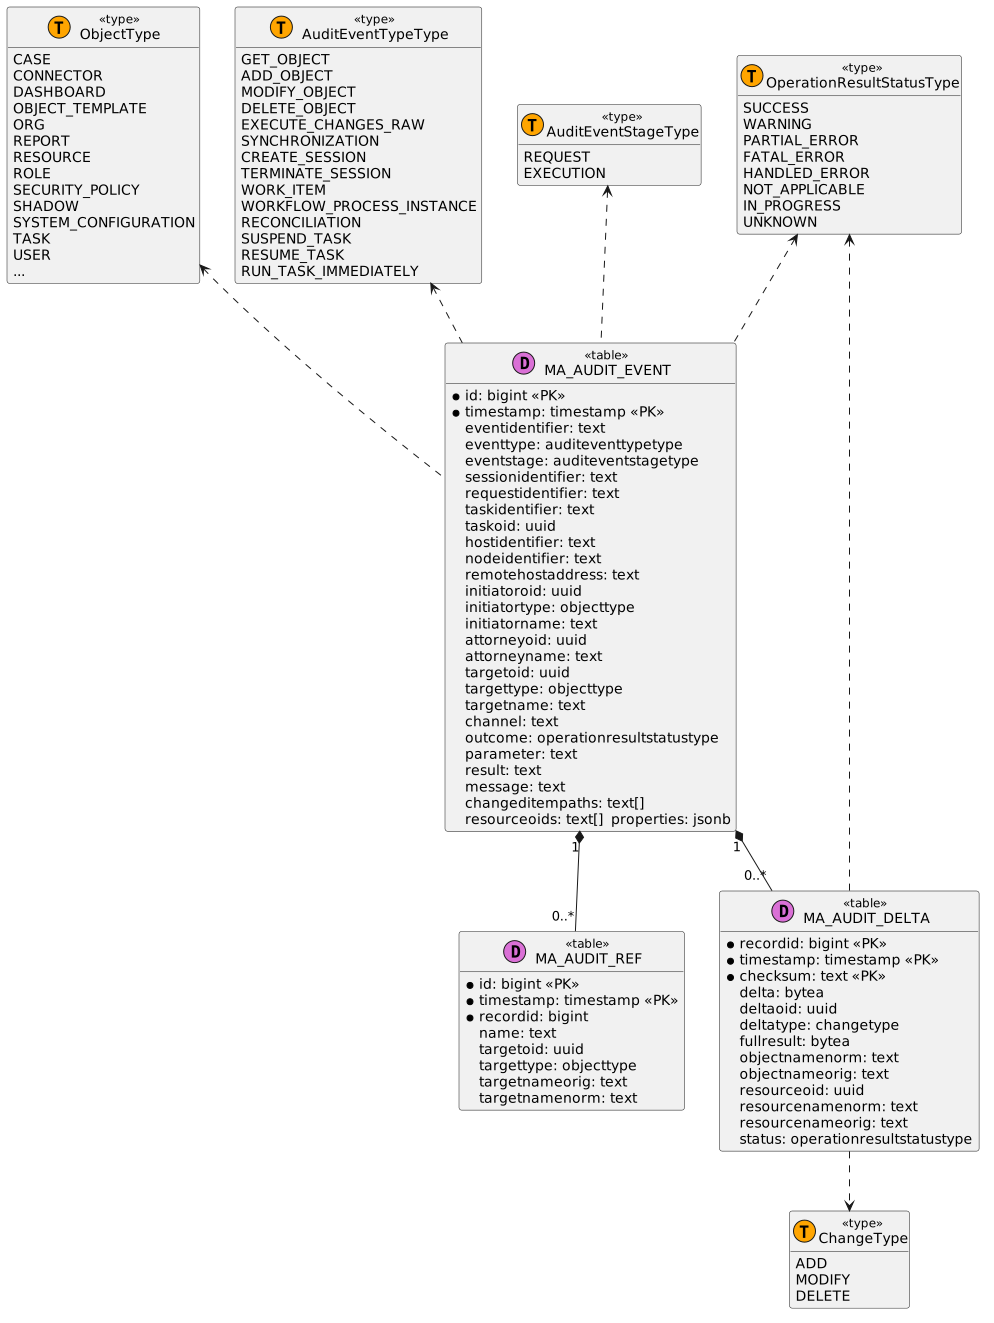
Логическая модель данных событий аудита в БД не меняется, это необходимо для сохранения обратной совместимости с имеющимся функционалом поиска событий аудита в UI IDM.
Информация по событиям аудита IDM хранится в таблицах:
MA_AUDIT_EVENT- таблица с событиями аудита, созданными на основании родительских операций;MA_AUDIT_DELTA- таблица с информацией о дочерних операциях (deltas);MA_AUDIT_REF- таблица с информацией о связанных объектах, используется для детализации событий аудита в рамках процессов утверждения выдачи доступов (WORK_ITEMиWORKFLOW_PROCESS_INSTANCE).
Связи между событиями аудита#
Ввиду специфики работы продукта, часть событий аудита связаны друг с другом. Данные связи обусловлены следующими факторами:
Для разных фаз (этапов) исполнения операций в IDM фиксируются отдельные события.
Этап исполнения
Описание
Пример события
REQUEST
ЗАПРОС - событие аудита соответствует запросу выполнения операции, операция еще не выполнена.
Содержит информацию об исходных данных, переданных при запуске операции.Модификация фамилии в карточке сотрудника, атрибут familyName
EXECUTION
ИСПОЛНЕНИЕ - событие аудита соответствует исполнению операции, то есть операция уже выполнена.
Содержит информацию о фактических данных, использованных при выполнении операции. В продукте предусмотрена дополнительная логика, отрабатывающая автоматически для различных операций (mappings, политики, hooks), таким образом исходные данные, переданные на этапе REQUEST, могут отличаться от фактически отработанных данных, вычисленных к моменту выполнения операции.Модификация фамилии и полного имени в карточке сотрудника, атрибуты familyName и fullName
Одна операция в IDM может породить множество дочерних. Дочерние операции описываются дельтами (deltas) и представляют из себя изменения объектов: создание, модификация или удаление.
Например, родительская операция изменения фамилии в карточке породит также изменение всех привязанных УЗ сотрудника, в которые передается значение фамилии. При этом некоторые операции родительского уровня (например, вход пользователя в систему) не предполагают создания дочерних.
С учетом указанных связей, топология событий аудита в рамках одной операции может быть представлена следующим образом:
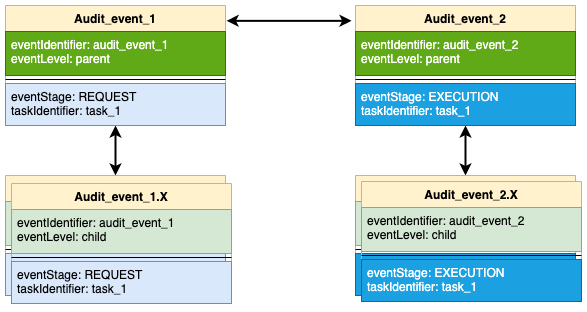
Все события объединены общим идентификатором операции - taskIdentifier. В дочерних (eventLevel: child) событиях аудита в атрибуте eventIdentifier указаны идентификаторы их родительских (eventLevel: parent) событий.
Целевая модель данных#
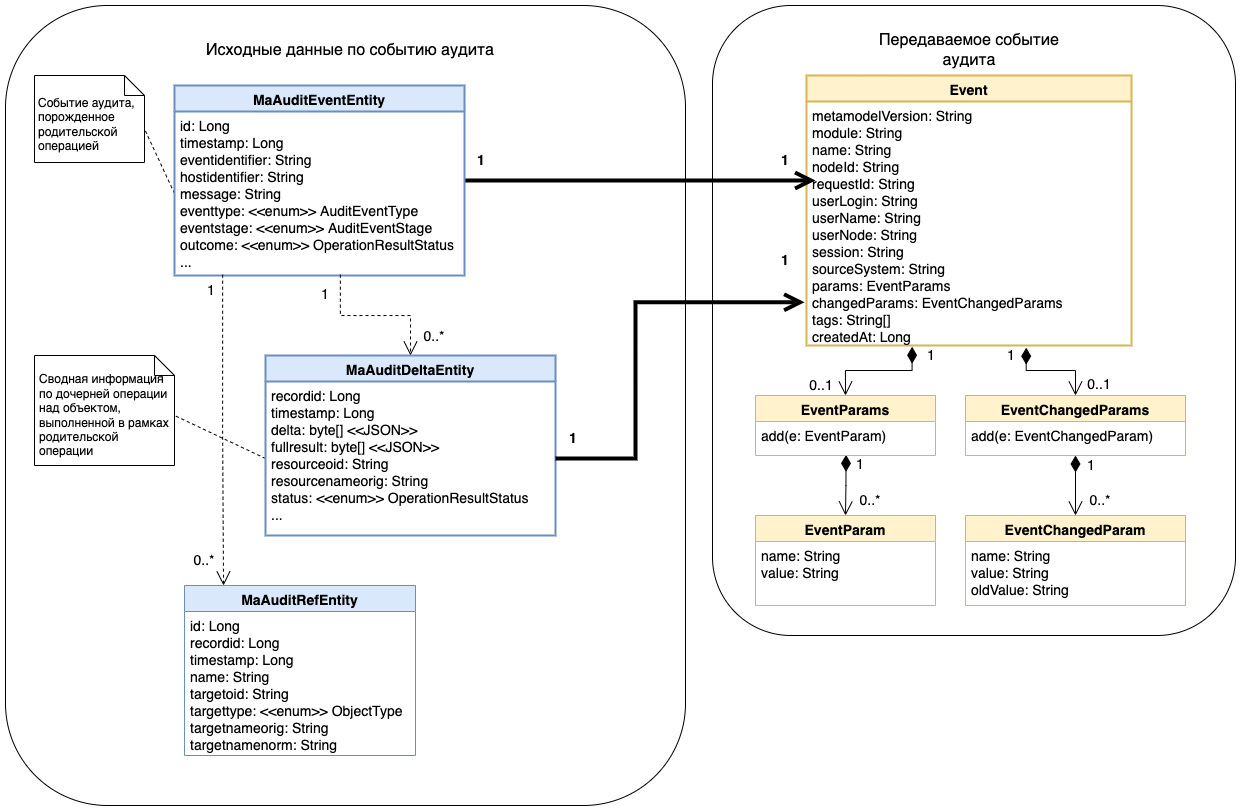
В качестве источника данных по событиям аудита выступают таблицы в БД IDM Audit DB с информацией о событиях аудита.
Одному объекту MaAuditEventEntity (запись из таблицы MA_AUDIT_EVENT) соответствует одно событие аудита - объект класса Event.
Для каждого связанного объекта MaAuditDeltaEntity (запись из таблицы MA_AUDIT_DELTA), которые содержат информацию о дочерних операциях, также создается свое отдельное событие аудита - объект класса Event.
Мониторинг idmx-datapipe#
Для контроля работы сервиса idmx-datapipe предоставляет набор метрик Prometheus на эндпоинт <хост idmx-datapipe>/actuator/prometheus.
В предоставляемые метрики входит стандартный набор метрик SpringBoot и JVM, а также дополнительные метрики работы самого idmx-datapipe.
Список метрик idmx-datapipe:
Название |
Описание |
Размерность |
Основные атрибуты |
|---|---|---|---|
|
Длительность процесса отправки событий аудита в Kafka |
Summary |
|
|
Наибольная длительность процесса отправки событий аудита в Kafka |
Gauge |
|
|
Количество событий в таблице |
Gauge |
|
|
Общее количество batch job в сервисе |
Counter |
— |
|
Runnable статус batch job, 0 - не готова к запуску, 1 - готова к запуску |
Gauge |
|
|
Количество запусков batch job |
Counter |
|
|
Количество завершенных batch job со статусами |
Counter |
|
|
Время исполнения batch job, в мс |
Gauge |
|
|
Количество ошибок на этапах |
Counter |
|
|
Количество прочитанных из БД событий |
Counter |
|
|
Количество отправленных в Kafka событий |
Counter |
|
|
Количество пропущенных событий |
Counter |
|
|
Количество событий в таблице |
Gauge |
|
|
Количество событий в таблице |
Gauge |
|
Lucene запросы для фильтрации сообщений#
Для более удобного поиска событий аудита по специфическим действиям в интерфейсе Platform V Audit SE можно воспользоваться следующими Lucene запросами:
Событие |
Пример запроса |
Примечание |
|---|---|---|
Вход пользователя в систему |
|
— |
Ошибка входа пользователя в систему |
|
— |
Выход пользователя из системы |
|
— |
Создание объекта |
|
Все типы объектов, все фазы, все уровни |
Ошибка создания объекта |
|
Все типы объектов, все фазы, все уровни |
Удаление объекта |
|
Все типы объектов, все фазы, все уровни |
Ошибка удаления объекта |
|
Все типы объектов, все фазы, все уровни |
Изменение объекта |
|
Все типы объектов, все фазы, все уровни |
Ошибка изменения объекта |
|
Все типы объектов, все фазы, все уровни |
Создание или исполнение процесса утверждения |
|
— |
Создание или исполнение задачи утверждения |
|
— |
Изменение объекта через его RAW-представление (xml) |
|
— |
Ошибка изменения объекта через его RAW-представление (xml) |
|
— |
Синхронизация объектов |
|
— |
Ошибка синхронизации объектов |
|
— |
Немедленный запуск задачи |
|
— |
Ошибка немедленного запуска задачи |
|
— |
Приостановка задачи |
|
— |
Ошибка приостановки задачи |
|
— |
Возобновление задачи |
|
— |
Ошибка возобновления задачи |
|
— |
Создание УЗ IDM |
|
— |
Создание УЗ |
|
— |
Ошибка создания УЗ |
|
— |
Удаление УЗ |
|
— |
Ошибка удаления УЗ |
|
— |
Блокирование/Разблокирование УЗ |
|
— |
Ошибка блокирования/разблокирования УЗ |
|
— |
Назначение роли в IDM |
|
Назначение роли на пользователей |
Ошибка назначения роли в IDM |
|
— |
Назначение роли в АС |
|
Параметр, по которому происходит фильтрация (здесь - «name»), зависит от конкретной конфигурации схемы данных в инсталляции |
Ошибка назначения роли в АС |
|
— |
Действия над учетной записью в АС |
|
— |