Руководство оператора коннектора Kafka#
Введение#
Функционал Rate limiter предназначен для ограничения обработки потоков требований, поступивших из Kafka в IDM, для применения в целевых системах. Он позволяет ограничивать число обрабатываемых требований в разрезе ресурса за заданный промежуток времени.
Верхнеуровневое описание алгоритма#
Требования поступают в IDM, используя Kafka коннектор с помощью задач Kafka Import URM и Kafka Import AUTO-EXECUTION. Для каждого требования создается Generic Object с меткой «Imported Kafka actions request» для дальнейшей обработки.
Обработка требований выполняется с помощью задач Kafka Actions Runner URM и Kafka Actions Runner Auto-Execution, обработка требований в очереди отложенных - с помощью задачи Kafka Pending Actions Runner. Если механизм Rate Limiter выключен, то при импорте требования сразу обрабатываются и направляются в целевые системы. Если механизм включен, используются квоты на количество обработанных сообщений за промежуток времени. Все требования, для которых выделена квота, будут сразу обработаны задачей. Все требования, для которых не выделена квота, будут отложены, и они смогут быть обработаны данной задачей после окончания промежутка в рамках новой квоты (когда будет выделена новая квота).
Для выключения Rate Limiting со сбросом всех настроек для ресурсов, соответствующих фильтру, используется задача Kafka Rate Limit Cleaner.
Для удаления обработанных отложенных требований используется задача Kafka Clear Processed Actions.
Запросы к базе данных, которые формирует механизм:
запрос карточки;
запрос системной конфигурации;
запросы ролей;
запросы ресурсов;
запрос проекций;
запросы в аудит;
запросы на блокировки (jdbc lock).
Включение Rate Limiting и задание настроек#
Для включения Rate Limiting используется задача Kafka Rate Limit Setter. Задача запускается вручную, без расписания. В целевой ресурс проставляется метка Rate Limited Resource. Выбор целевых ресурсов осуществляется с помощью фильтра.
Пример задания фильтра для ресурсов, которые соответствуют двум коннекторам:
     <objects>
        <type>c:ResourceType</type>
        <query>
            <q:filter>
                <q:text>
                    connectorRef/@/name contains 'ScimConnector'
					or
					connectorRef/@/name contains 'SoapConnector'
                </q:text>
            </q:filter>
        </query>
    </objects>
Метка Rate Limited Resource в ресурсе:
    <effectiveMarkRef oid="5c8eb7ea-c9af-4ffd-a276-8882b9a239b3" relation="org:default" type="c:MarkType">
        <!-- Rate Limited Resource -->
    </effectiveMarkRef>
Также в системной конфигурации для включения Rate Limiting параметр useRateLimiting должен иметь значение true.
В разрезе ресурса Rate Limiting регулируется тремя параметрами:
Max Rate Limit Count Value- максимальное количество запросов за временной промежуток.Rate Limit Update Duration- временной промежуток.Rate Limit Start Date- время начала отсчета первого временного промежутка.
Данные параметры можно настроить в edit raw ресурса в блоке extension:
    <extension xmlns:xsi='http://www.w3.org/2001/XMLSchema-instance' xmlns:xsd='http://www.w3.org/2001/XMLSchema'>
        <maxRateLimitCount xsi:type="xsd:int">10000</maxRateLimitCount>
        <rateLimitUpdateDuration xsi:type="xsd:duration">PT1M</rateLimitUpdateDuration>
        <rateLimitStartDate xsi:type="xsd:dateTime">1970-01-01T00:00:00.000Z</rateLimitStartDate>
    </extension>
Также для конфигурирования параметра maxRateLimitCount можно использовать интерфейс. Так же в UI отображается метка Rate Limited Resource. Данный параметр можно изменить в ресурсе во вкладке Basic под пользователями с ролью 6 Admin expert:
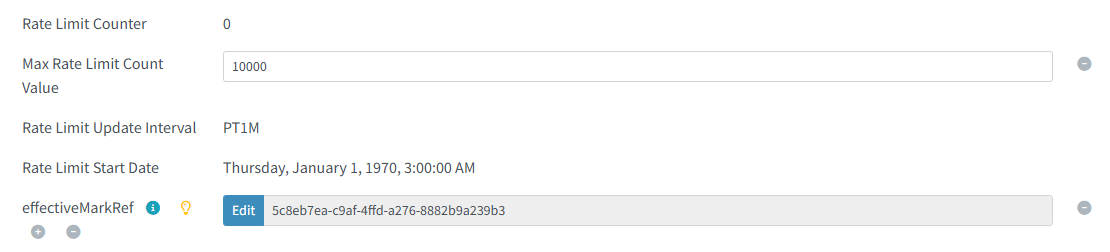
Также есть вспомогательные параметры, которые отображаются в ресурсе. Вручную данные параметры не изменяются. Они нужны для отслеживания текущего состояния Rate Limiting:
Rate Limit Counter- счетчик количества запросов за текущий временной промежуток.Previous Rate Limit Counter- счетчик количества запросов за предыдущий временной промежуток.Rate Limit Update Date- дата последнего обновления Previous Rate Limit Counter.Next Rate Limit Update Date- следующая дата обновления квоты.
Обновление всех параметров происходит в рамках выполнения задач Kafka Actions Runner URM и Kafka Actions Runner AUTO-EXECUTION.
Счетчик Rate Limit Counter увеличивается перед назначением или удалением назначения ролей. Для всех ресурсов, которые есть в индьюсменте первичной роли, проверяется наличие квоты. Для ресурсов, у которых квота есть, происходит увеличение счетчика. Если находится хотя бы один ресурс без свободной квоты, то увеличенные для других ресурсов счетчики откатываются.
Если хотя бы по одному из ресурсов нет квоты, то сообщение не обрабатывается (не отображается в статистике).
Limiter учитывается по всем зависимым ресурсам (то, что указано в inducement первичной роли и в inducement назначаемой роли, то, что указано в resourceOid назначаемой роли и то, что указано в проекции назначаемой роли. При учете inducement учитывается и ресурс и роль (например, если в первичную роль добавлена группа AD, то также будет учитываться квота ресурса AD).
В момент увеличения счетчика или проверки квоты поток пытается получить блокировку. Блокировка мультиподовая. Если блокировку получить не удалось, то поток ждет момент, когда она освободится. После изменения счетчика или проверки квоты блокировка снимается.
Получение требований#
Для получения требований используются задачи Kafka Import AUTO-EXECUTION и Kafka Import URM. Данные задачи считывает входящие требования из топиков. Требования импортируются из Kafka в IDM в виде shadow объектов. Для каждого требования создается Generic Object, соответствующий архетипу «UTM Action», с меткой «Imported Kafka actions request» для дальнейшей обработки. В созданном Generic Object содержится информация по ресурсам, ролям, каталогам ролей, требуемых для назначения/снятия ролей. Задачи Kafka Import не формируют ответ.
Периодичность запуска - 60 секунд. Задача вычитывает по 100 сообщений из каждой партиции. Коммит смещения происходит сразу после прочтения.
Рекомендуется перезапускать задачи Kafka Import с помощью задачи Retry task.
Обработка требований#
Для обработки требований используются задачи Kafka Actions Runner Auto-Execution и Kafka Actions Runner URM. Данные задачи проверяют доступность ресурса и, при наличии квоты, обрабатывают требование.
Задачи Kafka Actions Runner не учитывают состояние ресурса.
При обработке требования происходит проверка наличия квоты (происходит сравнение Rate Limit Counter и Max Rate Limit Count Value у всех ресурсов из индьюсмента роли первичной авторизации, причем ресурс AD определяется по наличию группы AD в индьюсменте. Роль может быть назначена в случае, когда у всех ресурсов из данного списка Rate Limit Counter < Max Rate Limit Count Value) и проверка меток:
Если за заданный временной промежуток было отправлено меньше требований, чем Max Rate Limit Count Value (квота на требование выделена), или в ресурсе Rate Limiting отключен, то требование обрабатывается сразу и направляется в целевой ресурс АС, если у пользователя для целевого ресурса нет отложенных назначений, иначе требование тоже становится отложенным. В Generic Object, соответствующий архетипу «UTM Action», проставляется метка «Processed Kafka actions request».
Если за заданный временной промежуток было отправлено больше требований, чем Max Rate Limit Count Value (квота на требование не выделена), то требования, которые выходят за границу этого значения, отправляются в отложенные. Для отложенных назначений в объект типа Generic Object, соответствующий архетипу «UTM Action», проставится метка «Postponed Kafka actions request». Данные объекты смогут быть обработаны задачей после окончания промежутка в рамках новой квоты (когда будет выделена новая квота).
Если целевой ресурс АС недоступен (находится в режиме Toggle Maintenance или не проходит Test Connection) и квота на требование выделена, то в Generic Object, соответствующий архетипу «UTM Action», проставляется метка «Processed Kafka actions request». Создается новый объект Generic Object, соответствующий архетипу «Pending UTM Action» с меткой «Postponed Kafka actions request», формируется и в топик отправляется ответ со статусом «pending». В целевой карточке пользователя происходит назначение/удаление ролей, но в проекции АС, куда должны уйти изменения, создается запись pendingOperation с отложенным назначением. После того, как ресурс станет доступен и изменения отправятся в целевую АС (произойдет рекомпьют), при обработке Generic Object с архетипом «Pending UTM Action» будут сверяться назначения из карточки пользователя и проекцией соответствующей АС. Если ресурс доступен, но в проекции еще не обработаны все pendingOperation, тогда не будут сверяться текущие назначения и проекция. Квота для «Pending UTM Action» не учитывается. Квота проверяется на момент обработки объекта «UTM-ACTION».
Задача обрабатывает объекты «UTM-ACTION» в порядке создания. После успешной обработки объекта, когда требование выполняется, и формируется ответ, метки «Processed Kafka actions request» и «Imported Kafka actions request» заменяются на метку «Processed Kafka actions request», формируется и в топик отправляется ответ.
Если целевой ресурс АС недоступен (находится в режиме Toggle Maintenance или не проходит Test Connection) и квота на требование не выделена, то в Generic Object, соответствующий архетипу «UTM Action», проставляется метка «Postponed Kafka actions request». Дальнейшая обработка будет происходить в соответствии с алгоритмом, изложенном в вышестоящих пунктах.
В конце временного отрезка выделяется новая квота и обновляются параметры Rate Limiting в разрезе ресурсов.
В конце выполнения требования происходит recompute, который необходим для актуализации проекций и проверки их целостности. Также recompute происходит в конце работы метода processKafkaAction для финальной актуализации проекций карточки. Количество recompute зависит от набора операций, совершаемых с ролями. Всегда есть 1 recompute. Еще по одному добавляют операции назначения и удаления назначения ролей.
Задачи Kafka Actions Runner состоит из activity Processing Kafka Action. Объекты забираются, согласно фильтрам:
<type>c:GenericObjectType</type>
<query>
    <q:filter>
        <q:text>
            archetypeRef matches (oid = "c33183e5-ec6b-436d-810b-5a74755fc48e")
            and
            effectiveMarkRef matches (oid = '38f9d47e-8391-420f-be4a-2586e660ae30')
        </q:text>
    </q:filter>
    <q:paging>
        <q:orderBy>metadata/createTimestamp</q:orderBy>
    </q:paging>
</query>
<type>c:GenericObjectType</type>
<query>
    <q:filter>
        <q:text>
            archetypeRef matches (oid = "954da938-bd2b-4b95-81ec-c5adbc1a800d")
            and
            (
            effectiveMarkRef matches (oid = 'ff09ab6b-f5d0-4ad1-ac19-be36bd3293d4')
            or
            effectiveMarkRef matches (oid = '38f9d47e-8391-420f-be4a-2586e660ae30')
            )
        </q:text>
    </q:filter>
    <q:paging>
        <q:orderBy>metadata/createTimestamp</q:orderBy>
    </q:paging>
</query>
Задачи Kafka Actions Runner за один запуск обрабатывают 50 объектов. Повторный запуск происходит через 20 секунд, после завершения работы таски. В рамках одного бакета объекты не добираются. Добор возможен, если объект попадет под фильтр еще не обработанного бакета.
Рекомендуется перезапускать задачи Kafka Actions Runner с помощью задачи Retry task.
Отложенные действия (Process Pending Kafka Action) обрабатываются задачей Kafka Pending Actions Runner. Данная задача работает аналогично задачам Kafka Actions Runner, но обрабатывает только объекты «PENDING-UTM-ACTION».
Алгоритм обработки требований#
При обработке требований выполняются следующие шаги:
Поиск источника ролей (каталог ролей или роли ресурса).
Поиск первичной роли.
Поиск назначаемых и отзываемых ролей
Поиск ролей учетной карточки.
Выполнение операций в требовании.
Отправка ответного сообщения с результатом операции.
Алгоритм поиска каталога ролей по serviceId#
Если в требовании задан serviceId, то каталог ролей следует искать по равенству serviceId и атрибута каталога ролей identifier.
Алгоритм поиска ролей по resourceId#
Поиск каталога ролей Если в требовании не задан
serviceIdи заданresourceId, то следует искать каталог ролей по равенствуresourceIdи атрибута каталога ролейextension/resourceOid. Если найдено несколько каталогов ролей, то следует выбрать каталоги, в которых есть первичные роли. Если таких каталогов несколько, то следует вернуть ошибку.Поиск первичной роли Алгоритм аналогичен случаю, когда задан
serviceId.
Среди ролей каталога с extension/resourceOid = resoruceId следует искать роли с архетипом Access role (64ddd757-29ae-455c-a6ee-591e1cf32f5e).
Поиск назначаемых и отзываемых ролей Алгоритм аналогичен случаю, когда задан
serviceId.
Среди ролей каталога с extension/resourceOid = resourceId следует искать роли с архетипами Resource Role (9c9c828a-dd8d-4cc7-9798-04c9c7ce14b2) и Active Directory Group (db15acfa-9fb9-4d8b-87cb-2907e78c70eb).
Поиск ролей карточки Алгоритм аналогичен случаю, когда задан
serviceId.
Среди ролей каталога с extension/resourceOid = resoruceId следует искать роли с архетипами Resource Role (9c9c828a-dd8d-4cc7-9798-04c9c7ce14b2), Active Directory Group (db15acfa-9fb9-4d8b-87cb-2907e78c70eb) и Access role (64ddd757-29ae-455c-a6ee-591e1cf32f5e).
Алгоритм пропуска расчета первичных ролей#
Добавлен атрибут catalogsWithoutCalculatePrimaryRoles. Значениями атрибута служат идентификаторы каталогов ролей, для которых расчет первичных ролей производить не следует. Для требований из таких каталогов не будут назначаться или отзываться первичные роли. Исключением служат случаи, когда в требовании передан атрибут accessRole со значениями grant или revoke.
Отзыв всех ролей#
Если roles.revokeAll = true, то у карточки отзываются все роли из каталога ролей с архетипами Resource Role (9c9c828a-dd8d-4cc7-9798-04c9c7ce14b2) и Active Directory Group (db15acfa-9fb9-4d8b-87cb-2907e78c70eb). Если accessRole = auto (исключая случай, когда первичная роль входит в каталог ролей, для которого первичную роль рассчитывать не нужно) или revoke, то в таком случае так же отзовется первичная роль.
Расчет ФОСов#
Список ФОСов передаются через атрибуты fosList.grant и fosList.revoke. Так как в json-схеме значения атрибута составные (имеют поля fosDictId и fosNodes), то в IDM они транслируются в строки. В IDM массивы fosList.grant и fosList.revoke имеют строковые значения.
fosDictId- идентификатор каталога ФОС ролей.fosNodes- список идентификаторов ФОС ролей.
Поиск ролей осуществляется в каталоге ролей с identifier = fosDictId. Роли должны иметь архетип Resource FOS role (851b1aa2-42bd-41e1-9a17-5cce6d1ae719) и effectiveStatus != disabled.
Для ФОС первичные роли не рассчитываются.
Требование должно обязательно содержать роли. Назначить или отозвать ФОС отдельно от роли нельзя.
Если fosList.revokeAll = true, то отзываются все ФОСы из каталогов ролей с identifier = fosList...fosDictId, кроме ролей из fosList.grant.
Приоритет атрибутов revokeAll и accessRole#
accessRole имеет наивысший приоритет над revokeAll и catalogsWithoutCalculatePrimaryRoles.
accessRole принимает следующие значения:
auto- Назначаем первичную роль, если ее нет и идет назначение других ролей. Отзываем первичную роль, если у карточки не осталось первичных ролей. Назначаем первичную роль, если у карточки есть активные роли из каталога. Отзыв и назначение первичной роли не привязаны к типу операции (назначение или отзыв ресурсной роли), система после отзыва должна проверять роли карточки, если у карточки есть ресурсные роли, то первичка должна назначаться. Аналогично при назначении ресурсных ролей может произойти отзыв первичной роли (например, попытка назначить отключенную роль. Такая роль не назначится, но первичка должна будет быть отозвана)grant- Назначить первичную роль, игнорируяrevokeAllиcatalogsWithoutCalculatePrimaryRoles. Если роль не найдена, то должна быть ошибка.revoke- Отозвать первичную роль, игнорируяcatalogsWithoutCalculatePrimaryRoles. Если роль не найдена, то должна быть ошибка.
Приоритеты: accessRole > revokeAll > catalogsWithoutCalculatePrimaryRoles.
Если accessRole = grant или revoke, а каталог ролей есть в списке catalogsWithoutCalculatePrimaryRoles, то для отзыва или назначения первичной роли будет производиться поиск. Если первичную роль не удалось найти или их было найдено несколько, то будет ошибка.
Обработка пустых списков ролей#
Если revokeAll = false, то в случае пустых списков будет ошибка.
Если roles.revokeAll = true, то допускается передача пустых списков или не передача вовсе roles.grant и roles.revoke.
Если fosList.revokeAll = true, то списки fosList.grant.fosNodes и fosList.revoke.fosNodes могут быть пустыми. fosDictId должен быть задан обязательно.
Допустима передача пустых списков roles.grant и roles.revoke, если переданы списки fosList.grant или fosList.revoke или fosList.revokeAll = true.
Формат ответного сообщения#
Ответное сообщение о статусе операции содержит следующие поля:
resource- имя ресурса.reqId- id запроса.description- описание.stackTrace- массив, содержащий трейс ошибки.initiator- oid пользователя, выполнившего запросuserLogin- имя пользователя, выполнившего запрос.result- результат операции.requestIds- id запросов требований.requestIdentifier- id запроса в IDM.channel- канал операции IDM.resourceId- id ресурса.serviceId- id сервиса.kafkaSource- источник требования (топик Kafka).accessModifyTimeStamp- время выполнения требования. Если требование не выполнялось, то он равенnull.
Выключение Rate Limiting с очисткой параметров#
Для отключения Rate Limiting используется задача Kafka Rate Limit Cleaner. Задача запускается вручную, без расписания. Выбор ресурсов для очистки параметров Rate Limiting осуществляется с помощью фильтра.
Пример задания фильтра для ресурсов, которые соответствуют двум коннекторам:
     <objects>
        <type>c:ResourceType</type>
        <query>
            <q:filter>
                <q:text>
                    connectorRef/@/name contains 'ScimConnector'
					or
					connectorRef/@/name contains 'SoapConnector'
                </q:text>
            </q:filter>
        </query>
    </objects>
Очистка обработанных требований#
Для удаления обработанных отложенных требований используется задача Kafka Clear Processed Actions . Задача запускается по расписанию каждые 2 часа. Данная задача удаляет объекты Generic Object, соответствующие архетипу «UTM Action» и «Pending UTM Action» с меткой «Processed Kafka actions request». Использованный shadow объект так же удаляется.
Удаляются только объекты, созданные более, чем 2 часа назад. Поиск производится по фильтру:
    <q:filter>
        <q:text>
            (
                (
                    archetypeRef matches (oid = "954da938-bd2b-4b95-81ec-c5adbc1a800d")
                    and
                    effectiveMarkRef matches (oid = 'e71da3e0-f956-49c0-85ba-2b5108157759')
                )
            or
                (
                    archetypeRef matches (oid = "c33183e5-ec6b-436d-810b-5a74755fc48e")
                    and
                    effectiveMarkRef matches (oid = 'e71da3e0-f956-49c0-85ba-2b5108157759')
                )
            )
            and
            metadata/modifyTimestamp < ```
            <!-- отнимаем 2 часа от текущего времени -->
            return basic.addMillis(basic.currentDateTime(), -7_200_000)
            ```
        </q:text>
    </q:filter>
Технологическая учетная запись#
Технологическая учетная запись kafka_technical_account обладает полномочиями назначать в карточки первичных ролей, прикладных ролей и ФОС автоматизированных систем, создавать и модифицировать проекций для УЗ в целевых ресурсах. Данная учетная запись является владельцем всех задач для работы с Kafka. При выполнении задач Kafka по расписанию в поле Initiator журнала аудита (Audit Log Viewer) отображается значение ТУЗ, обозначающее автоматизированный запуск процесса системой. Учетная запись предоставляется в составе дистрибутива.
Обработка архивных ролей#
При работе с поступающими требованиями по назначению или изъятию ролей происходит следующая обработка:
Проверяется существование активной роли с указанным в запросе идентификатором (oid). Один идентификатор должен соответствовать одной активной роли в IDM.
Если для указанного oid не найдено активной роли в IDM - возвращается ошибка.
Если для указанного oid найдено несколько активных ролей и/или фоснод в IDM - возвращается ошибка.
Если для одного oid роли найдена и архивная (
archive=true), и активная роли - в обработку берется активная, а архивная исключается из дальнейшей обработки.
Если в одном запросе на назначение указаны и активная роль, и неактивная (
archive=trueилиeffectiveStatus=Disabled) роль, то будет отклонен весь запрос на назначение с ошибкой «Найдены архивные роли: [role-id]».При изъятии ролей удаляются все роли, как активные, так и неактивные.
Просмотр логов#
Все действия, производимые компонентом IDMX (компонент idmx-engine) логируются, логи записываются в файлы на сервере. IDMX создает файлы журнала в директории /app/idmx-engine/var/log. Для включения логирования в файл нужно запустить задачу Set Kafka Logging.
Основной файл для работы - idm-engine.log. В него вносятся все логи работы IDMX.
В случае, если нужно получить логи интеграции с Kafka, то необходимо настроить категорию коннектора KafkaConnector.
Настроить категорию можно вручную согласно инструкции ниже.
Перейдите в UI IDM > Система > Логирование.
Перейдите в пункт Class loggers.
Нажмите кнопку + и добавьте категорию
ru.sbt.idmint.connector.kafka, выставив необходимый уровень логирования. В средах разработки и тестирования рекомендуется использование уровня TRACE. В PROD-среде рекомендуется использование уровня не ниже INFO.
Просмотр логов в Audit log Viewer#
Для отслеживания назначения требований используется Audit Log Viewer. Чтобы найти нужную запись, следуйте инструкции:
В IDM перейти в Audit Log Viewer.
В поиске по Request identifier ввести значение из списка атрибута
auditRequestIdнужного назначения. АтрибутauditRequestIdнаходится в ответном сообщении топика Kafka.Перейти в найденную запись в журнале аудита.
В записи аудита отображаются записи о фактах поступления и отправки сообщения в топик, информация о выполненном назначении, инициатор, канал (
urm/auto-execution/kafkaError), задача, oid задачи, идентификатор запроса (ReqId), идентификатор информационного ресурса (ServiceId), тело сообщения, отправляемого ресурсом в ответный топик (полеMessage), и т.д.
Просмотр метрик#
Для мониторинга всего процесса на каждом этапе обработки требований из Kafka в разрезе ресурсов используются следующие метрики:
idm_utm_queue_total - отражает общее количество запросов, импортированных задачей Kafka import и еще не обработанных задачейKafka Actions Runner.
idm_utm_postponed_total - отражает количество отложенных сообщений.
idm_utm_request_seconds - отражает среднее время выполнения запросов.
idm_utm_request_seconds_count - отражает время выполнения запроса Kafka.
idm_utm_request_seconds_bucket - отражает работу бакетов.
idm_utm_request_seconds_max - отражает максимальную наблюдаемую продолжительность выполнения запроса в пределах интервала затухания.
idm_utm_request_seconds_sum - отражает общую продолжительность выполнения всех запросов.