Как оценить состояние кластера#
Состояние кластера определяется совокупностью метрик и параметров, которые необходимо анализировать совместно. DataGrid способен обеспечивать высокую производительность в различных сценариях и при разной нагрузке. В общем случае работоспособным считается кластер, поведение которого соответствует ожидаемому. При этом существуют универсальные аспекты, на которые следует обращать внимание при любом развертывании.
Важно учитывать, что в работоспособном кластере могут происходить запланированные изменения топологии и временные всплески нагрузки.
Основные признаки работоспособного кластера:
Кластер находится в заданном состоянии и обслуживает только те операции, которые разрешены в этом состоянии.
Если базовая топология используется или изменяется вручную, она содержит ожидаемый набор серверных узлов, на которых должны храниться данные. Подробнее о топологии написано в разделе «Базовая топология» документа «Руководство разработчика».
Данные согласованы: команда
idle_verify, которая была запущена при отсутствии нагрузки на изменение данных, не обнаруживает расхождений между партициями.Все ожидаемые узлы находятся в топологии. В кластере нет незапланированных или повторяющихся событий
JOIN,LEFTиFAIL, а также сообщений о сегментации узлов.Потерянные партиции отсутствуют.
Количество и длительность LRT (длительных транзакций) не увеличиваются постоянно.
Активные процессы обмена информацией о расположении партиций (PME) завершаются.
Ребалансировка заканчивается (подробнее о ней написано в разделе «Ребалансировка» документа «Руководство разработчика»).
Метрики контрольных точек и размеры очередей пулов потоков возвращаются к обычным значениям после стабилизации топологии.
Единой команды или метрики, которая могла бы подтвердить работоспособность любого кластера, не существует. Ниже приведены рекомендации для проверки состояния кластера.
Проверка состояния кластера и состава топологии#
В приведенных ниже примерах запись control.(sh|bat) используется как сокращенное обозначение. В UNIX-подобных системах используется control.sh, в Windows — control.bat.
Проверка состояния кластера#
Выполните команду получения состояния кластера:
control.(sh|bat) --state
Пример части вывода команды:
Command [STATE] started
Arguments: --state
--------------------------------------------------------------------------------
Cluster state: ACTIVE
Command [STATE] finished with code: 0
Состояние ACTIVE ожидается при работе кластера в обычном режиме чтения и записи. Состояние ACTIVE_READ_ONLY является нормальным, если кластер намеренно переведен в режим только для чтения. Состояние INACTIVE допустимо только в том случае, если оно соответствует выполняемой операции, например запланированному техническому обслуживанию. Неактивный кластер не обслуживает операции с данными.
Критерий проверки — соответствие фактического состояния тому состоянию, которое было намеренно установлено для данного развертывания. Команды для просмотра и изменения состояния описаны в разделе «Утилита control» документа «Руководство администратора».
Проверка состава топологии#
Проверять базовую топологию следует в тех случаях, когда:
в кластере используется персистентность;
автоматическая настройка базовой топологии отключена;
набор серверных узлов, на которых хранятся данные, изменяется вручную.
В чистом in-memory-кластере с автоматической настройкой по умолчанию базовая топология сразу приводится в соответствие с текущей серверной топологией. Если автоматическая настройка отключена, базовая топология изменяется только по команде администратора. Если для автоматической настройки задан ненулевой тайм-аут, базовая топология обновляется только после того, как топология кластера остается неизменной в течение этого тайм-аута. В обоих случаях выполните команду получения control.(sh|bat) --baseline и сравните списки Baseline nodes и Other nodes с ожидаемым набором серверных узлов.
Пример части вывода для кластера, в котором все узлы базовой топологии доступны:
Cluster state: ACTIVE
Current topology version: 3
Baseline auto adjustment disabled: softTimeout=300000

Current topology version: 3 (Coordinator: ConsistentId=node-1, Order=1)

Baseline nodes:
    ConsistentId=node-1, State=ONLINE, Order=1
    ConsistentId=node-2, State=ONLINE, Order=2
    ConsistentId=node-3, State=ONLINE, Order=3
--------------------------------------------------------------------------------
Number of baseline nodes: 3

Other nodes not found.
Пример вывода, когда один узел базовой топологии недоступен:
Baseline nodes:
    ConsistentId=node-1, State=ONLINE, Order=1
    ConsistentId=node-2, State=OFFLINE, Order=2
    ConsistentId=node-3, State=ONLINE, Order=3
--------------------------------------------------------------------------------
Number of baseline nodes: 3
Состояние OFFLINE у узла базовой топологии означает, что ожидаемый серверный узел, на котором должны храниться данные, отсутствует. Если доступны другие основные или резервные копии, отсутствие этого узла не приводит к потере партиций. Чтобы проверить наличие потерянных партиций, запросите состояния партиций — подробнее об этом написано ниже в разделе «Убедитесь, что ребалансировка завершается».
Если серверный узел присоединился к кластеру, но не входит в базовую топологию, команда выводит его в списке Other nodes:
Other nodes:
    ConsistentId=node-4, Order=4
Number of other nodes: 1
Базовая топология содержит серверные узлы, которые предназначены для хранения данных, клиентские узлы в базовую топологию не входят. Наличие работающего серверного узла в списке Other nodes не всегда является ошибкой — например, узел мог быть намеренно запущен, но пока не введен в топологию данных.
Если узел должен хранить данные, сначала проверьте политику автоматической настройки базовой топологии и текущую процедуру технического обслуживания или горизонтального масштабирования. Затем измените базовую топологию в соответствии с процедурой. Изменение базовой топологии может запустить ребалансировку: партиции будут перераспределены в соответствии с новым аффинити-распределением. Учитывайте дополнительную нагрузку на сеть, CPU и дисковую подсистему, особенно в кластерах с включенной персистентностью.
Чтобы отличать запланированные операции от нестабильности, анализируйте изменения топологии. Когда серверный узел присоединяется к кластеру, покидает его или выходит из строя, состав кластера изменяется и запускается процесс PME. Запуск или остановка динамического кеша также может вызвать PME, даже если серверные узлы не присоединяются к кластеру и не покидают его. Поэтому изменение версии топологии или метрик PME следует анализировать вместе с проводимыми техническими работами и лог-файлами узлов. Используйте эти метрики для определения обычного диапазона значений в конкретном кластере, так как универсального порогового значения длительности PME не существует.
SELECT NAME, VALUE
FROM SYS.METRICS
WHERE NAME IN (
    'pme.Duration',
    'pme.CacheOperationsBlockedDuration'
)
ORDER BY NAME;
Если технические работы не выполняются, рекомендуется запускать control.(sh|bat) --baseline несколько раз или отслеживать метрики топологии, чтобы подтвердить стабильность состава кластера. В лог-файлах стоит обратить внимание на повторяющиеся события JOIN, LEFT, FAIL, сообщения о сегментации и сообщения потока exchange-worker.
Необходимо исследовать:
незапланированные повторяющиеся события
JOIN,LEFTиFAIL;сегментацию узлов;
сетевые сбои;
незавершающийся процесс PME.
Проверка метрик PME и транзакций описана ниже в разделе «Проверка транзакций и SQL-запросов».
Проверка согласованности партиций#
Когда в кластере отсутствует нагрузка на изменение данных, выполните команду:
control.(sh|bat) --cache idle_verify
Пример результата успешной проверки:
The check procedure has finished, no conflicts have been found.
Пример вывода при обнаружении расхождений:
The check procedure has failed, conflict partitions has been found: [counterConflicts=1, hashConflicts=0]
Update counter conflicts:
Conflict partition: PartitionKey [grpId=1544803905, grpName=default, partId=5]
Команда сравнивает счетчики обновлений и хеш-суммы основных и резервных копий партиций. Запускайте команду только при отсутствии активных изменений данных. Если данные меняются, команда может сообщить о ложноположительных расхождениях, так как во время вычисления хеш-сумм содержимое копий меняется.
Партиции в состояниях MOVING или LOST могут быть пропущены, поэтому результат проверки может оказаться неполным. Успешный результат idle_verify — важное подтверждение согласованности данных, но сам по себе он не доказывает, что кластер полностью работоспособен. Синтаксис команды и дополнительные ограничения описаны в подразделе «Проверка согласованности партиций» документа «Руководство администратора».
Убедитесь, что ребалансировка завершается#
Сразу после запланированного изменения топологии или операции с кешем могут появиться партиции в состояниях MOVING и RENTING. После стабилизации топологии повторите запрос и проверьте, что оба значения уменьшаются, а затем становятся равными нулю. Наличие партиций в состоянии LOST не является нормальным временным состоянием ребалансировки:
SELECT STATE, COUNT(*) AS PARTITION_COUNT
FROM SYS.PARTITION_STATES
WHERE STATE IN ('MOVING', 'RENTING', 'LOST')
GROUP BY STATE
ORDER BY STATE;
Также можно отслеживать локальные для узла метрики кеш-групп:
LocalNodeMovingPartitionsCount;LocalNodeRentingPartitionsCount;LocalNodeRentingEntriesCount.
Используйте системное представление SYS.PARTITION_STATES для проверки состояний партиций:
OWNING— узел является текущим владельцем основной или резервной копии партиции;MOVING— копия партиции загружается на узел во время ребалансировки;RENTING— после изменения владельцев старая копия партиции удаляется с узла;EVICTED— партиция отсутствует на узле, который больше не является ее владельцем (само по себе данное состояние не является ошибкой);LOST— партиция недоступна и не должна использоваться (необходимо немедленно определить причину).
SELECT CACHE_GROUP_ID, PARTITION_ID, NODE_ID, STATE, IS_PRIMARY
FROM SYS.PARTITION_STATES
WHERE STATE IN ('MOVING', 'RENTING', 'LOST')
ORDER BY STATE, CACHE_GROUP_ID, PARTITION_ID, NODE_ID;
В стабильном кластере данный запрос обычно не должен возвращать строки со состояниями MOVING, RENTING и LOST. Состояния MOVING и RENTING ожидаемы сразу после запланированного изменения топологии или операции с кешем, но количество таких партиций должно уменьшаться. Состояние LOST не является нормальным временным состоянием.
Пример вывода при потере одной партиции:
CACHE_GROUP_ID | PARTITION_ID | NODE_ID                              | STATE | IS_PRIMARY
1544803905     | 5            | 0f4d6f30-3e04-4f68-b6a2-6b89f1795c0d | LOST  | true
Если запрос возвращает состояние LOST, выполните процедуру восстановления из раздела «Политика потери партиций (Partition Loss Policy)» документа «Руководство разработчика». Если отказавший узел возвращается в кластер, его персистентные данные могут снова стать доступными, но затронутые партиции остаются в состоянии LOST. Когда необходимые данные снова станут доступными, сбросьте состояние потерянных партиций (перед сбросом убедитесь, что доступна хотя бы одна полная и актуальная копия каждой потерянной партиции).
В персистентном кластере сначала выполните штатную процедуру восстановления:
Верните в кластер все узлы базовой топологии до сброса состояния потерянных партиций или остановите кластер, запустите все узлы, включая отказавшие, и заново активируйте кластер.
Если некоторые узлы вернуть невозможно, исключайте их из базовой топологии только после определения, содержат ли их недоступные копии партиций данные, которые еще необходимо восстановить.
Пример#
У партиции есть одна основная и одна резервная копии на узлах A и B. После выхода узла A из топологии узел B может продолжить принимать изменения, пока он остается доступным. Если затем узел B выходит из строя и в кластер возвращается только узел A, на узле A может находиться устаревшая копия без изменений, которые узел B принял после выхода узла A.
После восстановления полной и актуальной копии партиции или после явного принятия потери недоступных изменений выполните команду сброса состояния потерянных партиций:
control.(sh|bat) --cache reset_lost_partitions cacheName1,cacheName2,...
Важно
Команда reset_lost_partitions только сбрасывает состояние LOST и не восстанавливает изменения, которые отсутствуют во всех доступных копиях.
Проверка очередей выполнения#
В DataGrid используется несколько внутренних пулов потоков. Обычный пул потоков выполняет задания из общей очереди. Под нагрузкой размеры очередей могут кратковременно увеличиваться, но они не должны расти непрерывно. Устойчивый рост очереди означает, что узел не успевает обрабатывать нагрузку или что нарушена обработка сообщений. Этот же принцип применяется к пулу StripedExecutor.
StripedExecutor распределяет внутренние задания кешей и транзакций между независимыми полосами (stripes). Задания в одной полосе выполняются последовательно, разные полосы могут работать параллельно. Если одна полоса заблокирована, связанные с ней задания могут накапливаться даже при невысокой общей утилизации CPU.
Проверьте метрики очередей на каждом серверном узле:
SELECT NAME, VALUE
FROM SYS.METRICS
WHERE NAME IN ('io.communication.OutboundMessagesQueueSize'
,'io.discovery.MessageWorkerQueueSize'
,'threadPools.StripedExecutor.TotalQueueSize'
,'threadPools.StripedExecutor.DetectStarvation'
)
   OR NAME LIKE 'threadPools.%.QueueSize'
ORDER BY NAME;
Если очередь StripedExecutor не уменьшается, проверьте находящиеся в ней задания:
SELECT STRIPE_INDEX, THREAD_NAME, TASK_NAME, DESCRIPTION
FROM SYS.STRIPED_THREADPOOL_QUEUE
ORDER BY STRIPE_INDEX, THREAD_NAME;
Кратковременное наличие заданий в очередях под нагрузкой допустимо. На узле без нагрузки размеры очередей обычно возвращаются к нулевому значению.
Необходимо исследовать:
непрерывный рост очередей;
очереди, которые не уменьшаются после прекращения нагрузки;
повторяющиеся значения
DetectStarvation=true;повторяющиеся предупреждения о «голодании» потоков (
starvation) в лог-файлах.
Универсального абсолютного порогового значения не существует — метрики очередей локальны для узла, поэтому их нужно собирать со всех серверных узлов.
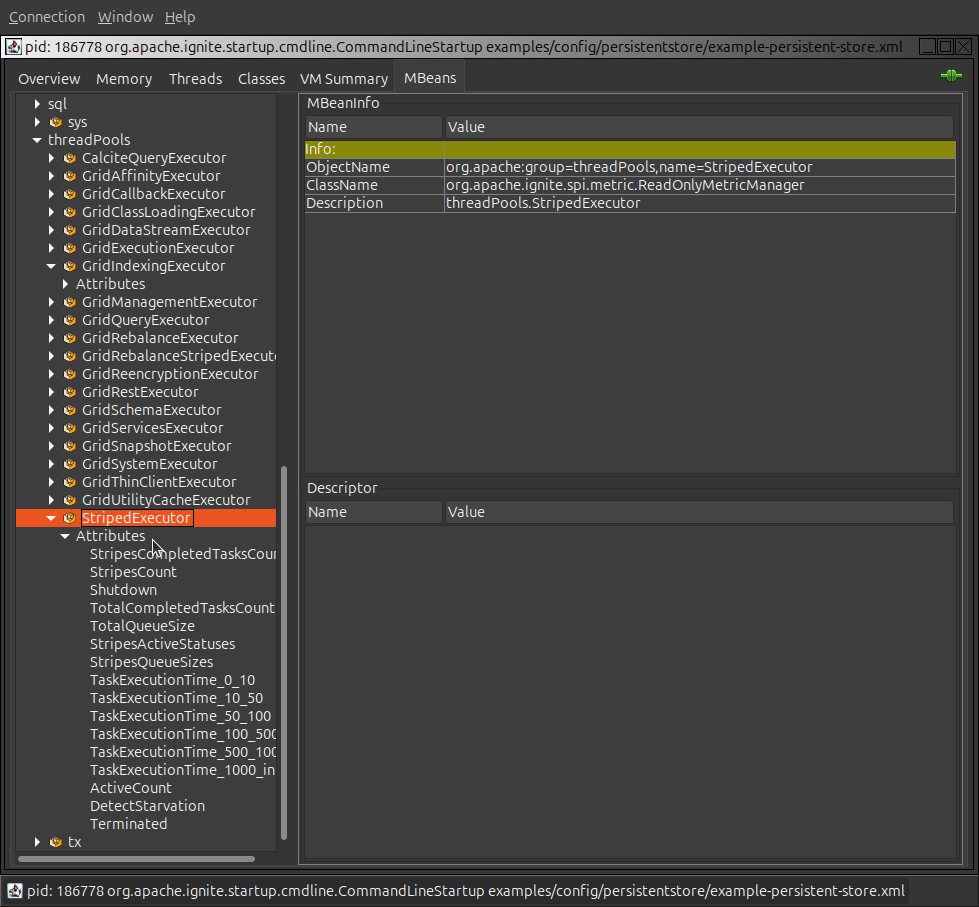
При формировании имени объекта MBean в JMX имя реестра метрик разделяется на свойства group и name. Для проверки очередей используются соответствия:
реестр
io.communicationпредставлен группой JMXioиMBeanс именемcommunication, атрибут —OutboundMessagesQueueSize;реестр
io.discoveryпредставлен группой JMXioиMBeanс именемdiscovery, атрибут —MessageWorkerQueueSize;реестр
threadPools.StripedExecutorпредставлен группой JMXthreadPoolsиMBeanс именемStripedExecutor, из атрибутов доступныTotalQueueSize,StripesQueueSizesиDetectStarvation;обычные пулы, например
threadPools.GridSystemExecutor, предоставляют атрибутQueueSize.
Доступ к метрикам с помощью JMX и SQL-представлений описан в разделе «Конфигурация экспортеров и включение метрик в New Metrics System» документа «Руководство администратора».
Локальные для узла метрики очередей StripedExecutor в jconsole:
Проверка транзакций и SQL-запросов#
Длительное выполнение транзакции или запроса само по себе не означает неисправность кластера. Нужно исследовать ситуацию, когда после снижения нагрузки продолжают увеличиваться количество или возраст активных операций или когда одни и те же операции регулярно блокируют другую работу.
Для вывода LRT используйте команду работы с транзакциями:
control.(sh|bat) --tx --min-duration 60 --servers --order DURATION
Важно
Значение 60 — пример диагностического фильтра в секундах, а не универсальное пороговое значение для промышленного контура.
Для просмотра текущих транзакций и SQL-запросов используйте системные представления:
SELECT XID, STATE, START_TIME, DURATION, KEYS_COUNT, LABEL
FROM SYS.TRANSACTIONS
ORDER BY DURATION DESC;
или:
SELECT QUERY_ID, START_TIME, DURATION, INITIATOR_ID, SQL
FROM SYS.SQL_QUERIES
ORDER BY DURATION DESC;
Для отслеживания связанных метрик используйте:
SELECT NAME, VALUE
FROM SYS.METRICS
WHERE NAME IN (
    'tx.OwnerTransactionsNumber',
    'tx.TransactionsHoldingLockNumber',
    'tx.LockedKeysNumber',
    'pme.Duration',
    'pme.CacheOperationsBlockedDuration'
)
ORDER BY NAME;
Ненулевые счетчики транзакций являются нормальными, пока выполняется прикладная нагрузка.
Признаки проблемы:
устойчивый рост счетчиков;
увеличение возраста самых старых операций;
невозврат показателей к обычному диапазону после снижения нагрузки.
Команда --tx описана в разделе «» документа «Руководство администратора». Диагностика LRT и длительных PME приведена в разделе «Часто встречающиеся проблемы и пути их устранения».
Проверка процессов PME#
PME (Partition Map Exchange) — процесс обмена информацией о расположении партиций между узлами кластера при изменении топологии или конфигурации кешей. На одном из этапов PME ожидает завершения незаконченных транзакций. Длительная транзакция может задержать присоединение узла, запуск кеша и другие операции, которые зависят от завершения PME.
Метод TransactionConfiguration.setTxTimeoutOnPartitionMapExchange(...) задает тайм-аут транзакций при PME. Значение по умолчанию — 0 (транзакции не откатываются из-за превышения тайм-аута PME). Тайм-аут начинает отсчитываться только после запуска PME. Незавершенные транзакции, длительность которых превысила настроенное значение, могут быть отменены. Приложения должны обрабатывать TransactionRollbackException и при необходимости повторять операцию.
Важно
Не используйте универсальное значение тайм-аута. Выберите значение, которое превышает обычную длительность допустимых транзакций с обоснованным запасом, и проверьте поведение приложения при откате транзакции. Дополнительная информация о длительных транзакциях и длительном PME указана в разделе «Часто встречающиеся проблемы и пути их устранения».
Проверка нагрузки при создании контрольных точек в персистентном режиме#
Проверка применима только к регионам данных, для которых включен Native Persistence. В чистом in-memory-кластере для in-memory-регионов данных контрольные точки (checkpoint) Persistence не создаются.
Во время создания контрольной точки DataGrid записывает «грязные» страницы из ОЗУ в файлы партиций. Создание контрольных точек — нормальный фоновый процесс. Проблема возникает, если скорость записи со стороны приложения превышает эффективную скорость записи дисковой подсистемы. При нехватке буфера контрольной точки или чрезмерном количестве «грязных» страниц DataGrid может ограничивать скорость потоков обновления. Если буфер контрольной точки исчерпан, обработка изменений может остановиться до завершения текущей контрольной точки.
Отслеживайте метрики регионов данных и хранилища:
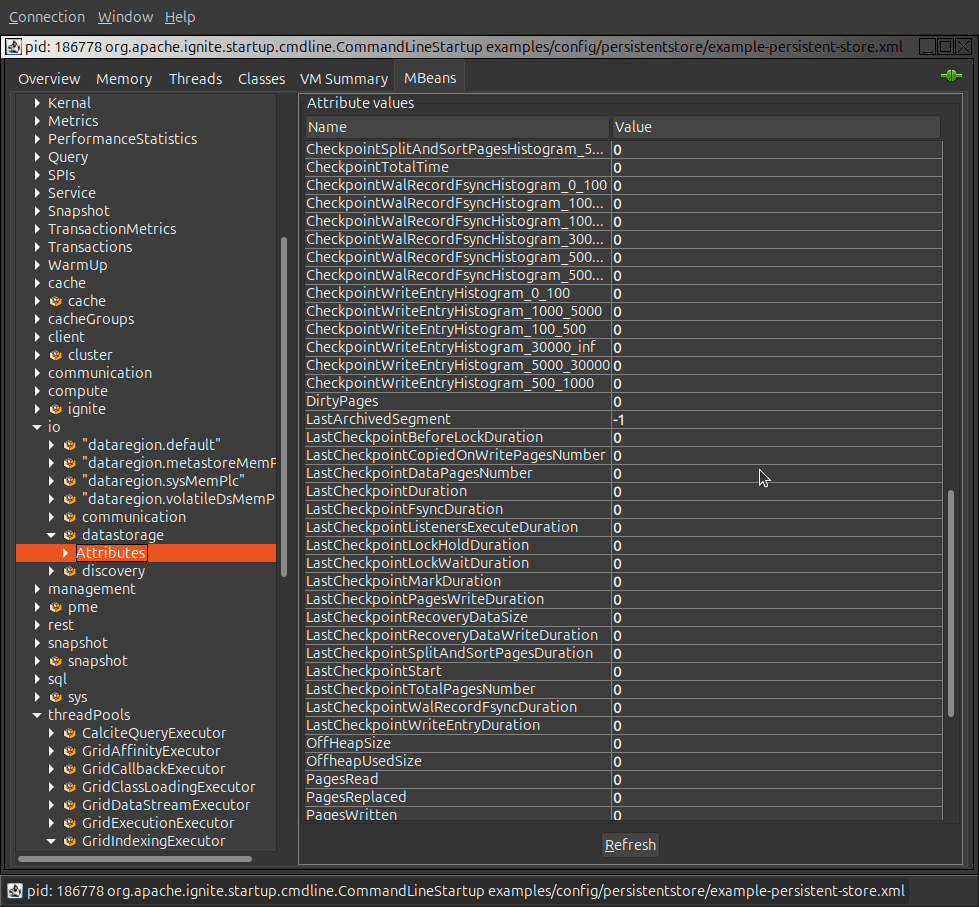
io.dataregion.<region>.DirtyPages;io.dataregion.<region>.CheckpointBufferSize;io.dataregion.<region>.UsedCheckpointBufferSize;io.dataregion.<region>.TotalThrottlingTime;io.datastorage.LastCheckpointStart;io.datastorage.LastCheckpointDuration;io.datastorage.LastCheckpointPagesWriteDuration;io.datastorage.LastCheckpointTotalPagesNumber;io.datastorage.LastCheckpointFsyncDuration.
В ignite.log записываются сообщения о контрольных точках:
[INFO ][db-checkpoint-thread-#][org.apache.ignite.internal.processors.cache.persistence.checkpoint.Checkpointer] Checkpoint started [checkpointId=<uuid>, startPtr=<wal-pointer>, checkpointBeforeLockTime=28ms, checkpointLockWait=0ms, checkpointListenersExecuteTime=27ms, checkpointLockHoldTime=30ms, walCpRecordFsyncDuration=7ms, splitAndSortCpPagesDuration=5ms, writeRecoveryDataDuration=3ms, writeCheckpointEntryDuration=1ms, pages=7837, reason='timeout']
[INFO ][db-checkpoint-thread-#][org.apache.ignite.internal.processors.cache.persistence.checkpoint.Checkpointer] Checkpoint finished [cpId=<uuid>, pages=7837, markPos=<wal-pointer>, walSegmentsCovered=[], markDuration=42ms, recoveryWrite=3ms, pagesWrite=41ms, fsync=31ms, total=147ms]
Плановые контрольные точки создаются с периодичностью, которая задается с помощью свойства DataStorageConfiguration.checkpointFrequency.
Повышенное количество «грязных» страниц, нехватка буфера контрольной точки и некоторые административные операции могут вызвать более ранний запуск контрольной точки. По последовательным значениям LastCheckpointStart можно оценить фактический интервал. Одна досрочная контрольная точка сама по себе не свидетельствует о проблеме. Регулярное сокращение интервала в сочетании с большим значением DirtyPages, высокой утилизацией UsedCheckpointBufferSize или ростом TotalThrottlingTime указывает на нехватку пропускной способности дисковой подсистемы или на чрезмерную нагрузку записи.
Приблизительная пропускная способность записи страниц контрольной точки в МиБ/с рассчитывается по формуле:
LastCheckpointTotalPagesNumber
* настроенное значение `DataStorageConfiguration.pageSize` в байтах
* 1000
/ `LastCheckpointPagesWriteDuration` в миллисекундах
/ 1048576
Не выполняйте расчет, если LastCheckpointPagesWriteDuration равно нулю, и используйте фактически настроенное значение DataStorageConfiguration.pageSize: размер страницы не всегда равен 4 КиБ.
Полученное значение является приблизительной оценкой, а не результатом полноценного тестирования диска. Сравните несколько контрольных точек и убедитесь, что пропускной способности достаточно для обычной нагрузки записи с необходимым запасом. Если запаса недостаточно:
проверьте задержки и утилизацию дисковой подсистемы вместе с метриками контрольных точек;
используйте более производительные диски промышленного класса;
размещайте файлы данных и WAL-журнал на разных физических устройствах, а не только в разных директориях одного диска;
проверьте настройки буфера контрольной точки и ограничения скорости записи страниц (троттлинг);
распределите нагрузку записи или добавьте серверные узлы, если это допускается эксплуатационными ограничениями;
проверьте, не конкурирует ли ввод-вывод архива WAL-журнала с вводом-выводом файлов данных.
Рекомендации по настройке приведены в разделе «Настройка Persistence» документа «Руководство разработчика». Диагностика медленной работы диска описана в разделе «Часто встречающиеся проблемы и пути их устранения».
JMX-метрики для контрольных точек и регионов данных локальны для узла. Проверяйте одинаковые графики или атрибуты на каждом серверном узле, на котором хранятся персистентные данные.
Локальные для узла метрики контрольных точек и персистентного региона в jconsole:
Проверка лог-файлов и дополнительных функций#
Проверьте лог-файлы и работу обработчика критических ошибок на наличие событий:
сегментация узлов;
повторяющиеся сообщения о блокировке системных рабочих потоков;
срабатывание обработчика критических ошибок;
OutOfMemoryErrorиIgniteOutOfMemoryException;повторяющиеся предупреждения о «голодании» потоков в
Striped pool;незапланированные перезапуски узлов.
DataGrid передает сведения о критических сбоях настроенному обработчику критических ошибок (FailureHandler). В зависимости от реализации обработчик может признать узел невалидным, запустить процедуру обработки отказа, остановить узел или завершить JVM.
На каждом серверном узле проверьте настроенный FailureHandler и значение его свойства ignoredFailureTypes. Если обработчик явно не настроен, DataGrid использует StopNodeOrHaltFailureHandler. По умолчанию AbstractFailureHandler игнорирует ошибки типа SYSTEM_WORKER_BLOCKED и SYSTEM_CRITICAL_OPERATION_TIMEOUT. Если эксплуатационная политика требует, чтобы обработчик реагировал на эти ошибки, удалите соответствующие значения из ignoredFailureTypes. При запуске каждого узла проверьте в лог-файле информацию о настроенном обработчике. Также необходимо обращать внимание на сообщения о критических и проигнорированных ошибках.
Настройка обработчиков и проверка критически важных потоков описаны в разделе «Обработка исключений» документа «Руководство разработчика».
Ни одна локальная команда не гарантирует отсутствие Split Brain (сетевой сегментации, которая приводит к разделению кластера на изолированные группы узлов). Контролируйте состав кластера из всех предусмотренных точек мониторинга и используйте лог-файлы и обработчик критических ошибок для обнаружения сегментации и сбоев Discovery. Подробнее о Split Brain написано в разделе «Защита от Split Brain» документа «Руководство разработчика».
Проверка CDC относится только к кластерам, в которых используется эта функция, и не входит в универсальное определение работоспособности кластера. Если CDC включен:
проверьте
ignite-cdc.logна наличие ошибок запуска, ошибок потребителя и сообщений о пропущенных WAL-сегментах;отслеживайте метрики
CurrentSegmentIndex,CommittedSegmentIndex,CommittedSegmentOffset,LastSegmentConsumptionTimeиSegmentConsumingTime;при наличии нагрузки записи убедитесь, что позиции текущего и зафиксированного сегментов продолжают увеличиваться;
настройте уведомления при устойчивом увеличении размера каталога CDC и занимаемого им дискового пространства;
добавьте и отслеживайте специфичные для потребителя метрики задержки обработки и доставки.
Конфигурация, метрики, обработка пропущенных сегментов и повторная отправка данных кеша описаны в разделе «Механизм Change Data Capture (CDC) и межкластерная репликация» документа «Руководство администратора».