Мониторинг#
События мониторинга#
События мониторинга показывают, что происходит в кластере DropApp Plus при изменении состояния или ошибках, вызванных другими ресурсами системы. События — это тип ресурса, который автоматически создается всеми основными компонентами и расширениями в кластере через API-сервер.
Доступ к логам событий можно получить напрямую из кластера при помощи команды oc.
Чтобы получить список событий, запустите команду, которая выводит список событий по определенному ресурсу или всему кластеру DropApp Plus.
DropApp Plus включает предварительно настроенный, предустановленный и самообновляемый стек, который обеспечивает мониторинг основных компонентов. Существует возможность включить мониторинг для пользовательских проектов.
Настройка#
Администратор кластера может настроить стек мониторинга с использованием поддерживаемых конфигураций.
По умолчанию включен набор оповещений, которые немедленно уведомляют администраторов кластера о проблемах. Панели мониторинга по умолчанию в веб-консоли OKD включают визуальное представление показателей кластера.
С помощью веб-консоли OKD возможно просматривать показатели, оповещения и управлять ими, а также просматривать информационные панели мониторинга. DropApp Plus также предоставляет доступ к сторонним интерфейсам, таким как Prometheus и Grafana.
После установки DropApp Plus администраторы кластера могут дополнительно включить мониторинг пользовательских проектов. Используя эту функцию, администраторы кластера, разработчики и другие пользователи могут указать, как отслеживать службы и модули в их собственных проектах.
Стек мониторинга#
Стек мониторинга DropApp Plus основан на проекте с открытым исходным кодом Prometheus и его экосистеме. Стек мониторинга включает в себя следующее:
Компоненты мониторинга платформы по умолчанию. Набор компонентов мониторинга платформы устанавливается в проект openshift-monitoring по умолчанию при установке DropApp Plus. Это обеспечивает мониторинг основных компонентов DropApp Plus, включая службы Kubernetes. Стек мониторинга по умолчанию также обеспечивает удаленный мониторинг работоспособности кластеров. Эти компоненты показаны в разделе «Установлено по умолчанию» на схеме.
Компоненты для мониторинга пользовательских проектов. После опционального включения мониторинга для пользовательских проектов в проект openshift-user-workload-monitoring устанавливаются дополнительные компоненты мониторинга. Это обеспечивает мониторинг пользовательских проектов. Эти компоненты показаны в разделе «Пользователь» на схеме.
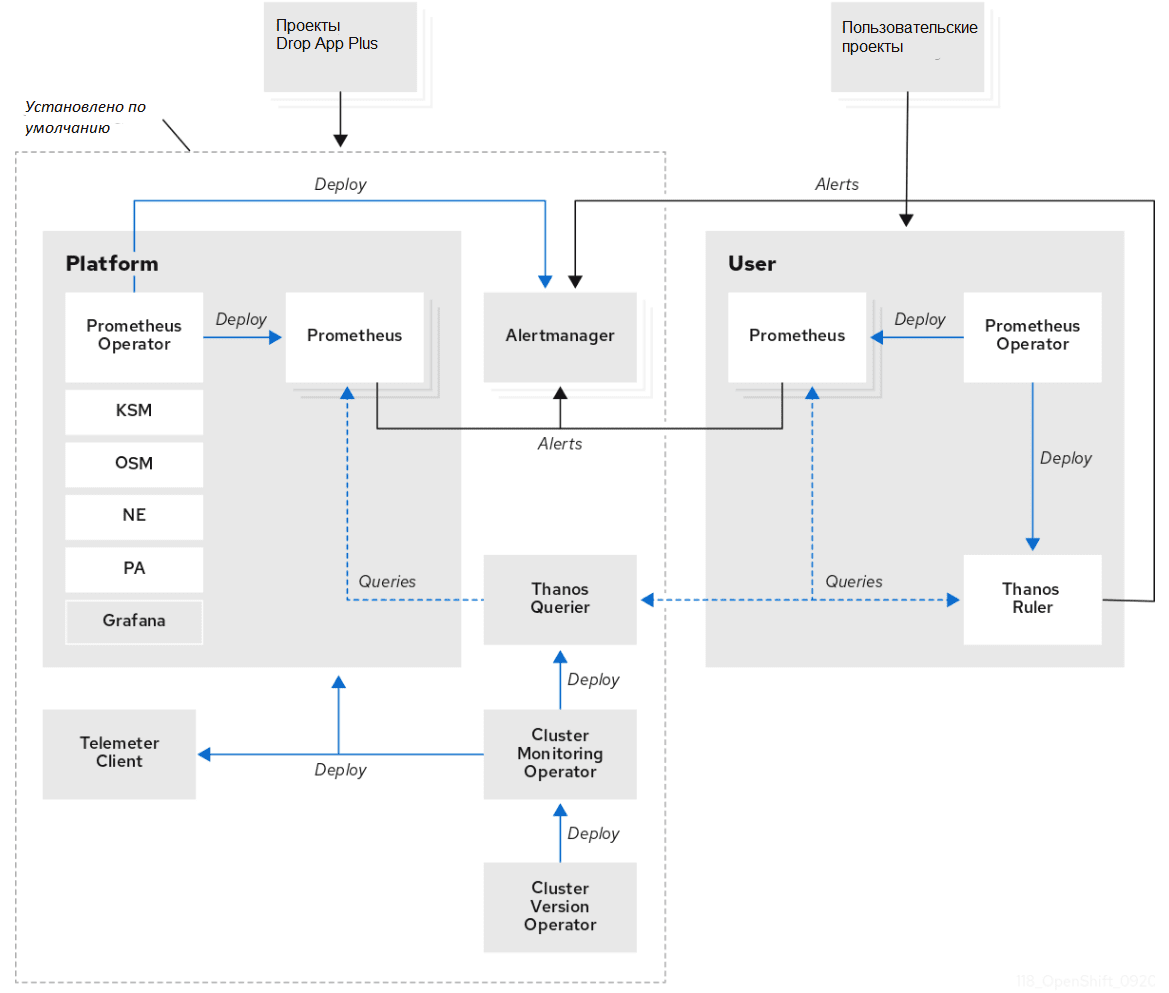
Компоненты мониторинга по умолчанию#
По умолчанию стек мониторинга DropApp Plus включает в себя следующие компоненты:
Компонент |
Описание |
|---|---|
Cluster Monitoring Operator |
Развертывает, управляет и автоматически обновляет экземпляры Prometheus и Alertmanager, Thanos Querier, Telemeter Client и целевые показатели метрик. Cluster Monitoring Operator развертывается оператором версий кластера (CVO). Центральный компонент стека мониторинга |
Prometheus Operator |
Создает, настраивает и управляет экземплярами Prometheus и экземплярами Alertmanager. Также автоматически генерирует целевые конфигурации мониторинга на основе запросов меток |
Prometheus |
Является базой данных временных рядов и механизмом оценки правил для метрик. Prometheus отправляет оповещения в Alertmanager для обработки |
Prometheus Adapter |
Преобразует запросы узлов и pod для использования в Prometheus. Преобразуемые показатели ресурсов включают показатели использования ЦП и памяти. Адаптер Prometheus предоставляет API метрик ресурсов кластера для горизонтального автоматического масштабирования pod. Адаптер Prometheus также используется командами |
Alertmanager |
Обрабатывает оповещения, полученные от Prometheus. Alertmanager также отвечает за отправку оповещений во внешние системы уведомлений |
kube-state-metrics agent |
Преобразует объекты DropApp Plus в метрики, которые может использовать Prometheus. |
openshift-state-metrics agent |
Расширяет kube-state-metrics за счет добавления показателей для ресурсов, специфичных для DropApp Plus. |
node-exporter agent |
Собирает метрики о каждом узле кластера. Развертывается на каждом узле. |
Thanos Querier |
Объединяет и, при необходимости, дедуплицирует основные метрики DropApp Plus и метрики для определяемых пользователем проектов в едином многопользовательском интерфейсе |
Grafana |
Предоставляет информационные панели для анализа и визуализации показателей. Экземпляр Grafana, поставляемый со стеком мониторинга вместе с панелями мониторинга, доступен только для чтения |
Telemeter Client |
Отправляет часть данных из экземпляров платформы Prometheus, чтобы облегчить удаленный мониторинг работоспособности кластеров |
Все компоненты в стеке мониторинга автоматически обновляются при обновлении DropApp Plus.
Цели мониторинга по умолчанию#
Cтек мониторинга по умолчанию отслеживает:
CoreDNS;
Elasticsearch (if Logging is installed);
etcd;
Fluentd (if Logging is installed);
HAProxy;
Image registry;
Kubelets;
Kubernetes API server;
Kubernetes controller manager;
Kubernetes scheduler;
Metering (if Metering is installed);
OpenShift API server;
OpenShift Controller Manager;
Operator Lifecycle Manager (OLM).
Компоненты мониторинга пользовательских проектов#
DropApp Plus включает в себя дополнительное усовершенствование стека мониторинга, которое позволяет отслеживать службы и pod в определяемых пользователем проектах. Эта функция включает в себя следующие компоненты:
Компонент |
Описание |
|---|---|
Prometheus Operator |
Оператор, который создает, настраивает и управляет экземплярами Prometheus и Thanos Ruler в одном проекте |
Prometheus |
Система мониторинга, с помощью которой осуществляется мониторинг определяемых пользователем проектов. Prometheus отправляет оповещения в Alertmanager для обработки |
Thanos Ruler |
Механизм оценки правил для Prometheus, который развертывается как отдельный процесс. В DropApp Plus Thanos Ruler обеспечивает оценку правил и предупреждений для мониторинга пользовательских проектов |
Цели мониторинга пользовательских проектов#
Если мониторинг включен для пользовательских проектов, возможно отслеживать:
Метрики, предоставляемые через эндпоинты службы в определяемых пользователем проектах;
Pod, работающие в определяемых пользователем проектах.
Сообщения администратору#
Примеры сообщений приведены в разделах «Сценарии администрирования» и «Сценарии эксплуатации кластера DropApp с помощью oc».
Метрики#
Метрики кластера#
Общие метки для всех метрик мастер-узлов:
Метка |
Значение |
|---|---|
|
Имя кластера |
|
Идентификатор кластера |
Метрики мастер-узла:
Название |
Описание |
Размерность |
Основные атрибуты |
|---|---|---|---|
|
Утилизация процессора |
% |
DGAUGE |
|
Утилизация памяти |
% |
DGAUGE |
Метрики узлов#
Общие метки для всех метрик узлов:
Метка |
Значение |
|---|---|
|
Имя кластера |
|
Идентификатор узлов |
Метрики узлов:
Название |
Описание |
Размерность |
Основные атрибуты |
|---|---|---|---|
|
Количество доступных ресурсов процессора узла |
% |
DGAUGE |
|
Совокупная загрузка процессора на всех ядрах, используемых узлом |
миллисекунды |
COUNTER |
|
Общее количество процессорных ядер узла |
шт |
DGAUGE |
|
Количество доступных ресурсов эфемерного хранилища узла |
байты |
IGAUGE |
|
Число свободных индексных дескрипторов |
шт |
IGAUGE |
|
Общее число индексных дескрипторов |
шт |
IGAUGE |
|
Размер эфемерного хранилища |
байты |
IGAUGE |
|
Использование эфемерного хранилища узла |
байты |
IGAUGE |
|
Количество доступных ресурсов оперативной памяти узла |
байты |
IGAUGE |
|
Общий объем памяти узла |
байты |
IGAUGE |
|
Использование памяти узла |
байты |
IGAUGE |
|
Используемая память рабочего набора узла |
байты |
IGAUGE |
|
Входящий трафик (получено байтов из сети) |
байты |
COUNTER |
|
Исходящий трафик (передано байтов в сеть) |
байты |
COUNTER |
|
Ограничение количества идентификаторов процессов в узле |
шт |
IGAUGE |
|
Использование идентификаторов процессов в узле |
шт |
IGAUGE |
Метрики pod#
Общие метки для всех метрик pod:
Метка |
Значение |
|---|---|
|
Имя кластера |
|
Имя пространства имен |
|
Имя pod |
Метрики pod:
Название |
Описание |
Размерность |
Основные атрибуты |
|---|---|---|---|
|
Совокупная загрузка процессора на всех ядрах, используемых pod |
миллисекунды |
COUNTER |
|
Использование эфемерного хранилища pod |
байты |
IGAUGE |
|
Использование памяти pod |
байты |
IGAUGE |
|
Используемая память рабочего набора pod |
байты |
IGAUGE |
|
Входящий трафик (получено байтов из сети) |
байты |
COUNTER |
|
Исходящий трафик (передано байтов в сеть) |
байты |
COUNTER |
|
Общий объем временного тома |
байты |
IGAUGE |
|
Использование временного тома. Дополнительная метка |
байты |
IGAUGE |
|
Утилизация временного тома. Дополнительная метка |
% |
DGAUGE |
Метрики постоянного тома#
Общие метки для всех метрик постоянного тома:
Метка |
Значение |
|---|---|
|
Имя кластера |
|
Имя пространства имен |
|
Имя Persistent Volume Claim |
Метрики постоянного тома:
Название |
Описание |
Размерность |
Основные атрибуты |
|---|---|---|---|
|
Число свободных индексных дескрипторов |
шт |
IGAUGE |
|
Общее число индексных дескрипторов |
шт |
IGAUGEE |
|
Общий объем постоянного тома |
байты |
IGAUGE |
|
Использование постоянного тома |
байты |
IGAUGE |
|
Утилизация постоянного тома |
% |
DGAUGE |